---
# Só mude aqui!!!!
author: "Jair Malta e Wesley Pinheiro"
title: "Relatório de Aula Prática 03"
bibliography: referencias.bib
# A partir daqui nao faca alteracoes!!!!!
link-citations: true
csl: associacao-brasileira-de-normas-tecnicas-ipea.csl
subtitle: "<a href='https://bendeivide.github.io/courses/epaec/' target='_blank'>Estatística e Probabilidade</a> </br> <a href='https://bendeivide.github.io' target='_blank'>Prof. Ben Dêivide (DEFIM/CAP/UFSJ)</a>"
include-before-body: header.html
date: now
date-format: "DD/MM/YYYY, HH:mm"
lang: pt-BR
format:
html:
toc: true
number-sections: true
theme: bootstrap
#css: styles.css
code-fold: true
code-tools: true
execute:
echo: true
warning: false
message: false
---
```{r}
#| label: configuracao
#| include: false
library(tidyverse)
library(knitr)
library(kableExtra)
knitr::opts_chunk$set(
echo = TRUE,
warning = FALSE,
message = FALSE,
fig.align = "center",
fig.width = 9,
fig.height = 5.5
)
# Tema gráfico comum ao relatório
tema_relatorio <- theme_minimal(base_size = 12) +
theme(
plot.title = element_text(face = "bold", hjust = 0.5),
plot.subtitle = element_text(hjust = 0.5),
legend.position = "bottom"
)
```
::: {style="text-align: justify;"}
# 📌 Introdução
O controle tecnológico do concreto constitui etapa fundamental para a garantia da qualidade e da segurança das estruturas de concreto armado. Conforme estabelecido pela @ABNT12655 esse controle envolve a verificação sistemática das propriedades do concreto desde a dosagem até o endurecimento, buscando assegurar que o material atenda aos requisitos definidos em projeto.
No contexto da Engenharia Civil, a análise estatística dos dados de controle tecnológico permite identificar padrões, avaliar a conformidade dos lotes produzidos e apoiar decisões sobre aceitação, investigação ou rejeição de materiais. Entretanto, a confiabilidade dessas análises depende diretamente da qualidade dos dados utilizados, conforme destacado por @Neville2016
O presente trabalho utiliza uma base contendo 100 observações de corpos de prova de concreto, com informações sobre resistência à compressão, consumo de cimento, relação água/cimento, abatimento, densidade e absorção do agregado. A base apresenta problemas de qualidade que impedem sua utilização direta, incluindo:
- substituição do número zero pela letra O;
- uso inconsistente de vírgula e ponto como separadores decimais;
- categorias textuais não padronizadas;
- valores ausentes;
- variáveis quantitativas representadas como texto;
- valores potencialmente incompatíveis com o contexto físico.
# 🎯 Objetivos
## Objetivo geral
Realizar o diagnóstico, a limpeza e a análise exploratória de uma base de controle tecnológico do concreto utilizando prioritariamente ferramentas do ecossistema **Tidyverse**, @tidyverse, gerando informações úteis para a tomada de decisão na Engenharia Civil.
## Objetivos específicos
- importar a base sem alterar os dados brutos;
- inspecionar sua estrutura e representação;
- identificar valores ausentes, erros de digitação e inconsistências categóricas;
- produzir uma versão limpa e rastreável dos dados;
- gerar estatísticas descritivas gerais e por grupo;
- criar variáveis derivadas relacionadas ao desempenho do concreto;
- visualizar distribuições e relações relevantes com ggplot2;
- produzir informações que auxiliem o engenheiro responsável;
- comparar a lógica do Base R, @RCore2026, com o paradigma do Tidyverse, @tidyverse.
# ⚙️ Metodologia
## Base de dados
A base utilizada é o arquivo base_processamento_dados_engenharia_civil.csv, composto por 100 observações e 10 variáveis. Para preservar os registros exatamente como foram fornecidos, a importação inicial será feita com todas as colunas como texto. A conversão para tipos numéricos ocorrerá somente na etapa de limpeza.
```{r}
#| label: tab-variaveis
#| tbl-cap: "Descrição das variáveis utilizadas no estudo"
tabela_variaveis <- tribble(
  ~Variavel, ~Descricao, ~Tipo_esperado,
  "id_corpo_prova", "Identificador único do corpo de prova", "Qualitativa",
  "obra", "Obra de origem do concreto", "Qualitativa",
  "tipo_concreto", "Classe de resistência do concreto", "Qualitativa",
  "idade_dias", "Idade do corpo de prova no ensaio, em dias", "Quantitativa",
  "resistencia_mpa", "Resistência à compressão, em MPa", "Quantitativa",
  "cimento_kg_m3", "Consumo de cimento, em kg/m³", "Quantitativa",
  "relacao_a_c", "Relação água/cimento", "Quantitativa",
  "abatimento_mm", "Abatimento do concreto, em mm", "Quantitativa",
  "densidade_kg_m3", "Densidade do concreto, em kg/m³", "Quantitativa",
  "absorcao_agregado_pct", "Absorção do agregado, em %", "Quantitativa"
)

kable(tabela_variaveis, booktabs = TRUE, align = c("l", "l", "c")) |>
  kable_styling(
    bootstrap_options = c("striped", "hover", "condensed"),
    full_width = FALSE,
    position = "center"
  ) |>
  scroll_box(width = "100%", height = "380px")
```
## Ferramentas utilizadas
Todas as etapas de processamento são realizadas prioritariamente com a família Tidyverse:
- readr: read_csv2(), parse_double() e parse_integer();
- dplyr: select(), filter(), mutate(), summarise(), group_by(), count(), distinct(), across(), case_when() e if_else();
- stringr: str_trim(), str_to_upper(), str_replace_all() e str_detect();
- tidyr: pivot_longer(), drop_na() e replace_na();
- purrr: map_dbl();
- ggplot2: ggplot(), geom_histogram(), geom_boxplot(), geom_col() e geom_point().
No script anterior, funções como tapply(), aggregate(), apply(), sapply(), ifelse(), ave() e subset() resolviam tarefas isoladas. No Tidyverse, a análise é organizada como um fluxo: o objeto entra pelo operador |>, passa por verbos de transformação e produz uma saída tabular ou gráfica. Essa estrutura tende a tornar o código mais legível, modular e fácil de auditar.
# 🔍 Resultados e discussão
## Importação e preservação da base original
A função read_csv2() é adequada para arquivos que usam ponto e vírgula como separador de campos e vírgula como separador decimal. O argumento show_col_types = FALSE suprime a exibição dos tipos de coluna.
```{r}
#| label: importacao
arquivo_dados <- "base_processamento_dados_engenharia_civil.csv"

if (!file.exists(arquivo_dados)) {
  stop("Arquivo não encontrado: ", arquivo_dados)
}

# Importar TUDO como texto para preservar os dados originais
dados <- read_csv2(
  arquivo_dados,
  col_types = cols(.default = col_character()),
  na = c("", " ", "NA", "N/A", "-", "null", "NULL"),
  show_col_types = FALSE
)
```
Diferentemente de read.csv2(), que pertence ao Base R, read_csv2() integra o pacote readr, retorna um tibble e fornece uma sintaxe consistente com as etapas posteriores do Tidyverse.
## Inspeção inicial
```{r}
#| label: inspecao-inicial
glimpse(dados)
```
A função glimpse() desempenha papel semelhante a str(), mas apresenta as colunas de maneira compacta e adequada a tibbles.
```{r}
#| label: tab-dimensoes
#| tbl-cap: "Dimensões da base importada"
dimensoes <- dados |>
  summarise(
    Observacoes = n(),
    Variaveis = ncol(dados)
  )

kable(dimensoes, align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
```{r}
#| label: tab-amostra
#| tbl-cap: "Primeiras observações da base bruta"
dados |>
  slice_head(n = 6) |>
  kable(align = "c") |>
  kable_styling(full_width = FALSE, position = "center") |>
  scroll_box(width = "100%")
```
Na Base R, seriam usadas funções separadas como head(), str() e dim(). No Tidyverse, slice_head(), glimpse() e summarise() mantêm a inspeção alinhada à mesma lógica de verbos aplicada em todo o relatório.
## Diagnóstico da qualidade dos dados
### Valores ausentes
```{r}
#| label: tab-na-variavel
#| tbl-cap: "Quantidade e percentual de valores ausentes por variável"
resumo_na <- dados |>
  summarise(
    across(
      everything(),
      list(
        quantidade = ~ sum(is.na(.x)),
        percentual = ~ mean(is.na(.x)) * 100
      ),
      .names = "{.col}_{.fn}"
    )
  ) |>
  pivot_longer(
    cols = everything(),
    names_to = c("Variavel", ".value"),
    names_pattern = "(.*)_(quantidade|percentual)$"
  ) |>
  filter(quantidade > 0) |>
  arrange(desc(quantidade), Variavel)

kable(resumo_na, digits = 2, align = c("l", "c", "c")) |>
  kable_styling(full_width = FALSE, position = "center")
```
No script em Base R, a contagem era realizada com sapply(). No Tidyverse, summarise() com across() aplica a mesma função a todas as colunas, enquanto pivot_longer() organiza o resultado em formato longo, mais adequado para leitura e visualização.
```{r}
#| label: tab-localizacao-na
#| tbl-cap: "Localização dos valores ausentes"
localizacao_na <- dados |>
  pivot_longer(
    cols = -id_corpo_prova,
    names_to = "item_ausente",
    values_to = "valor"
  ) |>
  filter(is.na(valor)) |>
  select(id_corpo_prova, item_ausente)

kable(localizacao_na, align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
### Inconsistências categóricas
```{r}
#| label: tab-categorias-brutas
#| tbl-cap: "Categorias observadas antes da padronização"
categorias_brutas <- bind_rows(
  dados |> count(categoria = obra, name = "frequencia") |> mutate(variavel = "obra"),
  dados |> count(categoria = tipo_concreto, name = "frequencia") |> mutate(variavel = "tipo_concreto")
) |>
  select(variavel, categoria, frequencia)

kable(categorias_brutas, align = c("l", "l", "c")) |>
  kable_styling(full_width = FALSE, position = "center")
```
A função count() substitui a combinação table() e conversões posteriores para data frame. Sua vantagem é retornar diretamente um tibble que pode continuar no fluxo de transformação.
### Problemas de representação numérica
```{r}
#| label: tab-erros-numericos
#| tbl-cap: "Registros com letras ou vírgulas em campos numéricos"
colunas_numericas_brutas <- c(
  "idade_dias", "resistencia_mpa", "cimento_kg_m3", "relacao_a_c",
  "abatimento_mm", "densidade_kg_m3", "absorção_agregado_pct"
)

erros_representacao <- dados |>
  pivot_longer(
    cols = all_of(colunas_numericas_brutas),
    names_to = "variavel",
    values_to = "valor_original"
  ) |>
  filter(str_detect(valor_original, "[Oo,]")) |>
  select(id_corpo_prova, variavel, valor_original)

kable(erros_representacao, align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
No Base R, essas buscas poderiam exigir gsub(), indexação lógica e chamadas repetidas. Com pivot_longer() e str_detect(), todas as colunas numéricas são investigadas com uma lógica única e explícita.
## Limpeza e conversão dos dados
A base original de dados não será alterada. A versão processada será armazenada em dados_limpos, preservando a rastreabilidade entre dados brutos e dados tratados.
```{r}
#| label: limpeza
# Função auxiliar baseada em stringr + readr.
# Ela corrige O/o por zero, troca vírgula por ponto e converte para double.
converter_numero <- function(x) {
  x |>
    str_trim() |>
    str_replace_all("[Oo]", "0") |>
    str_replace_all(",", ".") |>
    parse_double(
      locale = locale(decimal_mark = "."),
      na = c("", "NA", "N/A", "-", "null", "NULL")
    )
}

dados_limpos <- dados |>
  rename(absorcao_agregado_pct = `absorção_agregado_pct`) |>
  mutate(
    id_corpo_prova = str_trim(id_corpo_prova),
    obra = str_trim(obra),
    tipo_concreto = str_to_upper(str_trim(tipo_concreto)),
    idade_dias = parse_integer(str_trim(idade_dias)),
    across(
      c(
        resistencia_mpa,
        cimento_kg_m3,
        relacao_a_c,
        abatimento_mm,
        densidade_kg_m3,
        absorcao_agregado_pct
      ),
      converter_numero
    )
  )
```
Na solução anterior, cada coluna era tratada por uma sequência própria de gsub() e as.numeric(). Na solução Tidyverse, uma função de conversão reaproveitável é aplicada às colunas por meio de across(). Isso reduz repetição e garante que todas recebam o mesmo tratamento.
### Auditoria das alterações
```{r}
#| label: tab-auditoria
#| tbl-cap: "Auditoria dos registros textuais corrigidos"
auditoria_limpeza <- dados |>
  transmute(
    id_corpo_prova,
    obra_original = obra,
    obra_padronizada = str_trim(obra),
    tipo_original = tipo_concreto,
    tipo_padronizado = str_to_upper(str_trim(tipo_concreto))
  ) |>
  filter(
    obra_original != obra_padronizada |
      tipo_original != tipo_padronizado
  )

kable(auditoria_limpeza, align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
```{r}
#| label: tab-estrutura-limpa
#| tbl-cap: "Classes das variáveis após a limpeza"
estrutura_limpa <- dados_limpos |>
  summarise(across(everything(), ~ class(.x)[1])) |>
  pivot_longer(
    cols = everything(),
    names_to = "Variavel",
    values_to = "Classe"
  )

kable(estrutura_limpa, align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
## Investigação de valores potencialmente incompatíveis
Os limites abaixo são utilizados apenas como regras de triagem. Um registro sinalizado não é automaticamente excluído ou alterado. A decisão técnica deve considerar ficha de ensaio, método, tipo de concreto, materiais e condições de produção.
```{r}
#| label: tab-suspeitos
#| tbl-cap: "Valores que exigem investigação técnica"
valores_suspeitos <- dados_limpos |>
  filter(
    abatimento_mm > 300 |
      densidade_kg_m3 < 1000 |
      absorcao_agregado_pct > 4 |
      idade_dias > 100
  ) |>
  mutate(
    motivo_investigacao = case_when(
      abatimento_mm > 300 ~ "Abatimento acima do limite de triagem",
      densidade_kg_m3 < 1000 ~ "Densidade muito baixa para concreto convencional",
      absorcao_agregado_pct > 4 ~ "Absorção elevada para agregado convencional",
      idade_dias > 100 ~ "Idade de ensaio muito superior às idades usuais",
      TRUE ~ "Verificar"
    )
  ) |>
  select(
    id_corpo_prova, obra, tipo_concreto, idade_dias,
    abatimento_mm, densidade_kg_m3, absorcao_agregado_pct,
    motivo_investigacao
  )

kable(valores_suspeitos, align = "c") |>
  kable_styling(full_width = FALSE, position = "center") |>
  scroll_box(width = "100%")
```
A função filter() substitui subset(), enquanto case_when() substitui cadeias de ifelse(). A vantagem de case_when() é apresentar múltiplas condições de forma vertical, facilitando sua leitura e revisão.
### Decisão adotada
Neste relatório, os valores suspeitos são mantidos sem correção automática. Os registros de abatimento igual a 1250 mm e densidade igual a 238 kg/m³ são plausíveis como erros de digitação, mas sua alteração para 125 e 2380 exige confirmação na fonte original. O mesmo cuidado se aplica à absorção de 18,4% e à idade de 280 dias.
Caso a conferência documental confirme os erros, uma versão corrigida poderá ser criada sem modificar dados_limpos:
```{r}
#| label: exemplo-correcao
#| eval: false
# Executar somente após confirmação na ficha original do ensaio.
dados_corrigidos <- dados_limpos |>
  mutate(
    abatimento_mm = if_else(
      id_corpo_prova == "CP-032" & abatimento_mm == 1250,
      125,
      abatimento_mm
    ),
    densidade_kg_m3 = case_when(
      id_corpo_prova == "CP-053" & densidade_kg_m3 == 238 ~ 2380,
      TRUE ~ densidade_kg_m3
    )
  )
```
## Tratamento dos valores ausentes
### Decisão adotada para valores ausentes
Optou-se por manter todos os valores ausentes (NA) sem imputação ou exclusão, pelas seguintes razões:
- CP-015 (abatimento): manter NA. É uma variável secundária; a imputação poderia mascarar problemas reais de medição.
- CP-038 (relacao_a_c): manter NA. Embora possa ser estimada pela relação com cimento, a imputação poderia criar uma correlação artificial.
- CP-077 (densidade): manter NA. Variável secundária com apenas 1 valor ausente em 100 observações.
- CP-092 (resistencia): manter NA. Esta é a principal decisão. A resistência é a variável resposta central. Imputar seu valor poderia introduzir viés significativo nas análises estatísticas subsequentes.
- CP-097 (absorcao): manter NA. Variável secundária com apenas 1 valor ausente.
Justificativa geral: A imputação de valores, especialmente para a variável resposta (resistência), pode distorcer médias, desvios padrão e correlações. A exclusão de observações com NAs reduziria o tamanho amostral e poderia eliminar outras informações válidas. Portanto, manter os NAs e utilizar na.rm = TRUE nos cálculos é a abordagem mais conservadora e transparente.
```{r}
#| label: tab-na-limpos
#| tbl-cap: "Valores ausentes após a conversão"
dados_limpos |>
  summarise(across(everything(), ~ sum(is.na(.x)))) |>
  pivot_longer(
    everything(),
    names_to = "Variavel",
    values_to = "Quantidade_NA"
  ) |>
  filter(Quantidade_NA > 0) |>
  kable(align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
## Estatísticas descritivas
### Resumo geral da resistência
```{r}
#| label: tab-resumo-resistencia
#| tbl-cap: "Estatísticas descritivas da resistência à compressão"
resumo_resistencia <- dados_limpos |>
  summarise(
    n_validos = sum(!is.na(resistencia_mpa)),
    media_mpa = mean(resistencia_mpa, na.rm = TRUE),
    mediana_mpa = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao_mpa = sd(resistencia_mpa, na.rm = TRUE),
    coeficiente_variacao_pct = 100 * desvio_padrao_mpa / media_mpa,
    minimo_mpa = min(resistencia_mpa, na.rm = TRUE),
    q1_mpa = quantile(resistencia_mpa, 0.25, na.rm = TRUE),
    q3_mpa = quantile(resistencia_mpa, 0.75, na.rm = TRUE),
    maximo_mpa = max(resistencia_mpa, na.rm = TRUE)
  )

kable(resumo_resistencia, digits = 2, align = "c") |>
  kable_styling(full_width = FALSE, position = "center") |>
  scroll_box(width = "100%")
```
### Médias das variáveis quantitativas
```{r}
#| label: tab-medias-quantitativas
#| tbl-cap: "Médias das variáveis quantitativas"
medias_quantitativas <- dados_limpos |>
  select(where(is.numeric)) |>
  summarise(across(everything(), ~ mean(.x, na.rm = TRUE))) |>
  pivot_longer(
    everything(),
    names_to = "Variavel",
    values_to = "Media"
  )

kable(medias_quantitativas, digits = 2, align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
Essa operação substitui apply(..., MARGIN = 2, mean). Com across(where(is.numeric), ...), a seleção das colunas e a função aplicada ficam explícitas, sem converter o tibble em matriz.
### Uso de purrr
```{r}
#| label: medias-purrr
medias_com_purrr <- dados_limpos |>
  select(where(is.numeric)) |>
  map_dbl(~ mean(.x, na.rm = TRUE))

medias_com_purrr
```
A função map_dbl() é uma alternativa a sapply() quando se deseja garantir um vetor numérico como saída. O sufixo _dbl documenta o tipo esperado e torna o comportamento mais previsível.
## Estatísticas por agrupamento
### Resistência por obra
```{r}
#| label: tab-resistencia-obra
#| tbl-cap: "Resistência à compressão por obra"
resumo_por_obra <- dados_limpos |>
  group_by(obra) |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    media_mpa = mean(resistencia_mpa, na.rm = TRUE),
    mediana_mpa = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao_mpa = sd(resistencia_mpa, na.rm = TRUE),
    cv_pct = 100 * desvio_padrao_mpa / media_mpa,
    .groups = "drop"
  ) |>
  arrange(desc(media_mpa))

kable(resumo_por_obra, digits = 2, align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
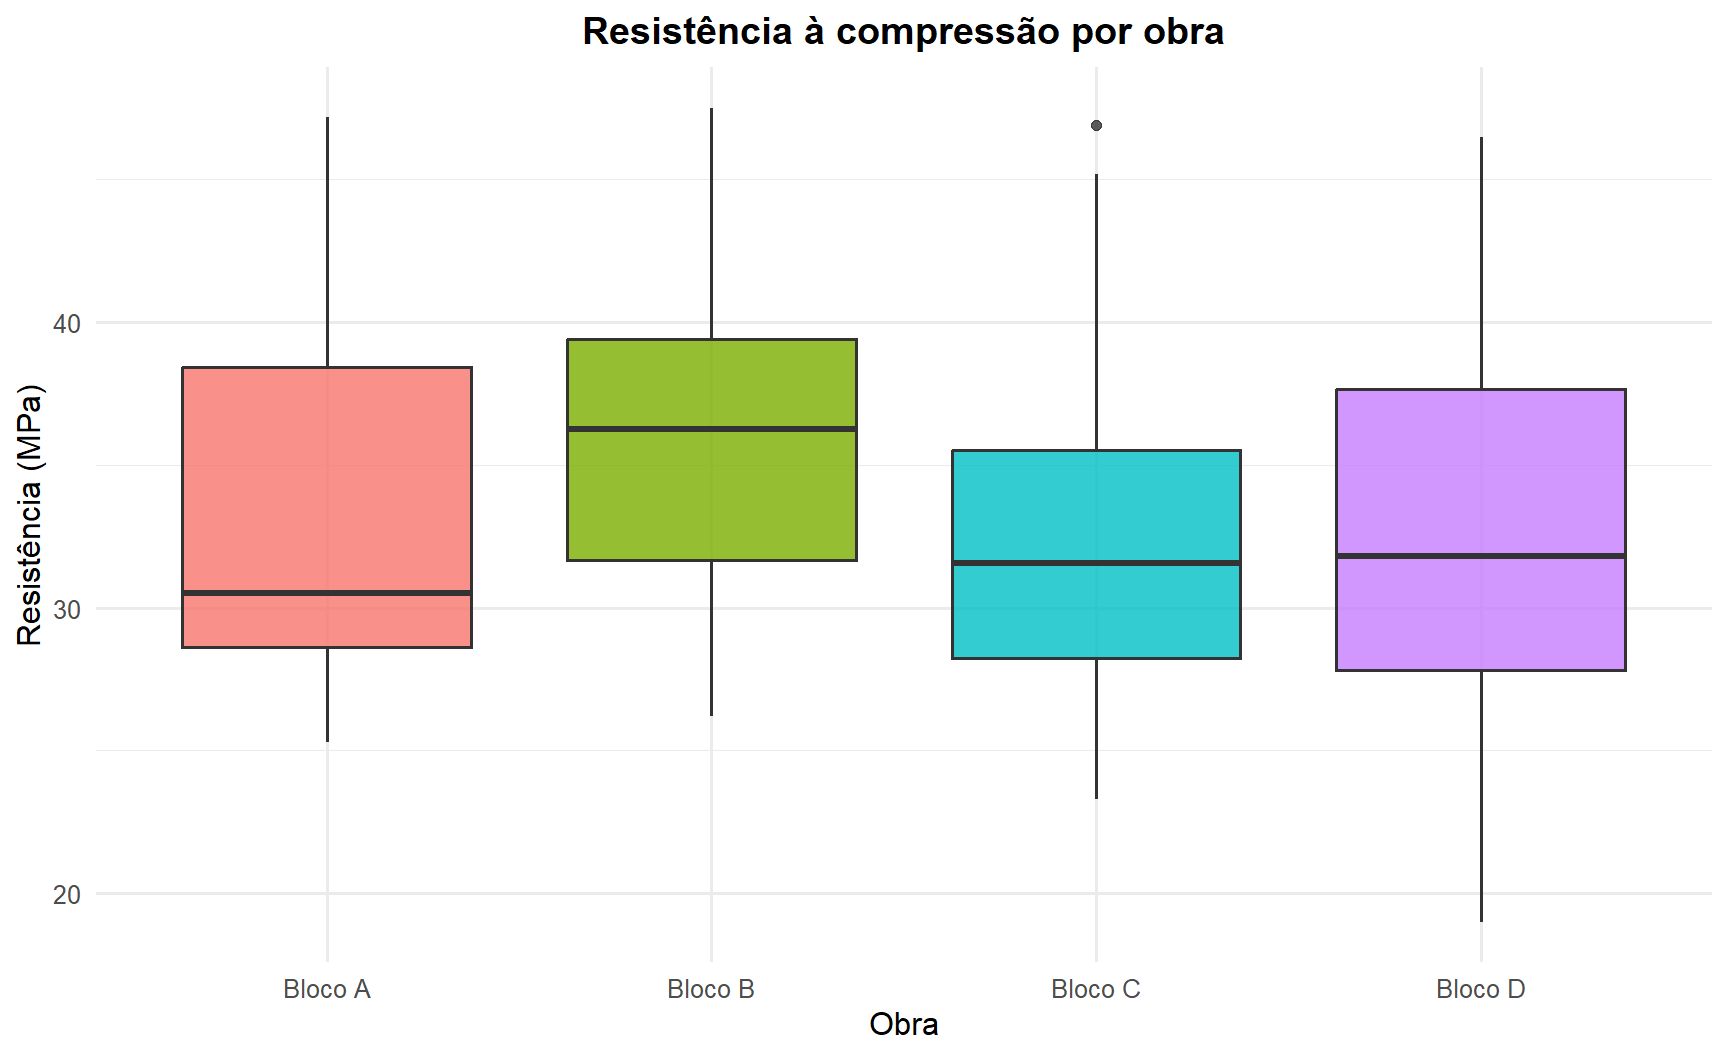
A função group_by() define os grupos e summarise() calcula as estatísticas. Esse conjunto substitui tapply() e também parte das aplicações de aggregate(), com a vantagem de retornar um tibble nomeado e pronto para novos filtros, ordenações e gráficos.
```{r}
#| label: fig-boxplot-obra
#| fig-cap: "Distribuição da resistência à compressão por obra"
ggplot(dados_limpos, aes(x = obra, y = resistencia_mpa, fill = obra)) +
  geom_boxplot(alpha = 0.8, na.rm = TRUE, show.legend = FALSE) +
  labs(
    title = "Resistência à compressão por obra",
    x = "Obra",
    y = "Resistência (MPa)"
  ) +
  tema_relatorio
```
### Resistência por tipo de concreto
```{r}
#| label: tab-resistencia-tipo
#| tbl-cap: "Resumo da resistência por classe de concreto"
resumo_por_tipo <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    media_mpa = mean(resistencia_mpa, na.rm = TRUE),
    mediana_mpa = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao_mpa = sd(resistencia_mpa, na.rm = TRUE),
    cv_pct = 100 * desvio_padrao_mpa / media_mpa,
    minimo_mpa = min(resistencia_mpa, na.rm = TRUE),
    maximo_mpa = max(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(tipo_concreto)

kable(resumo_por_tipo, digits = 2, align = "c") |>
  kable_styling(full_width = FALSE, position = "center") |>
  scroll_box(width = "100%")
```
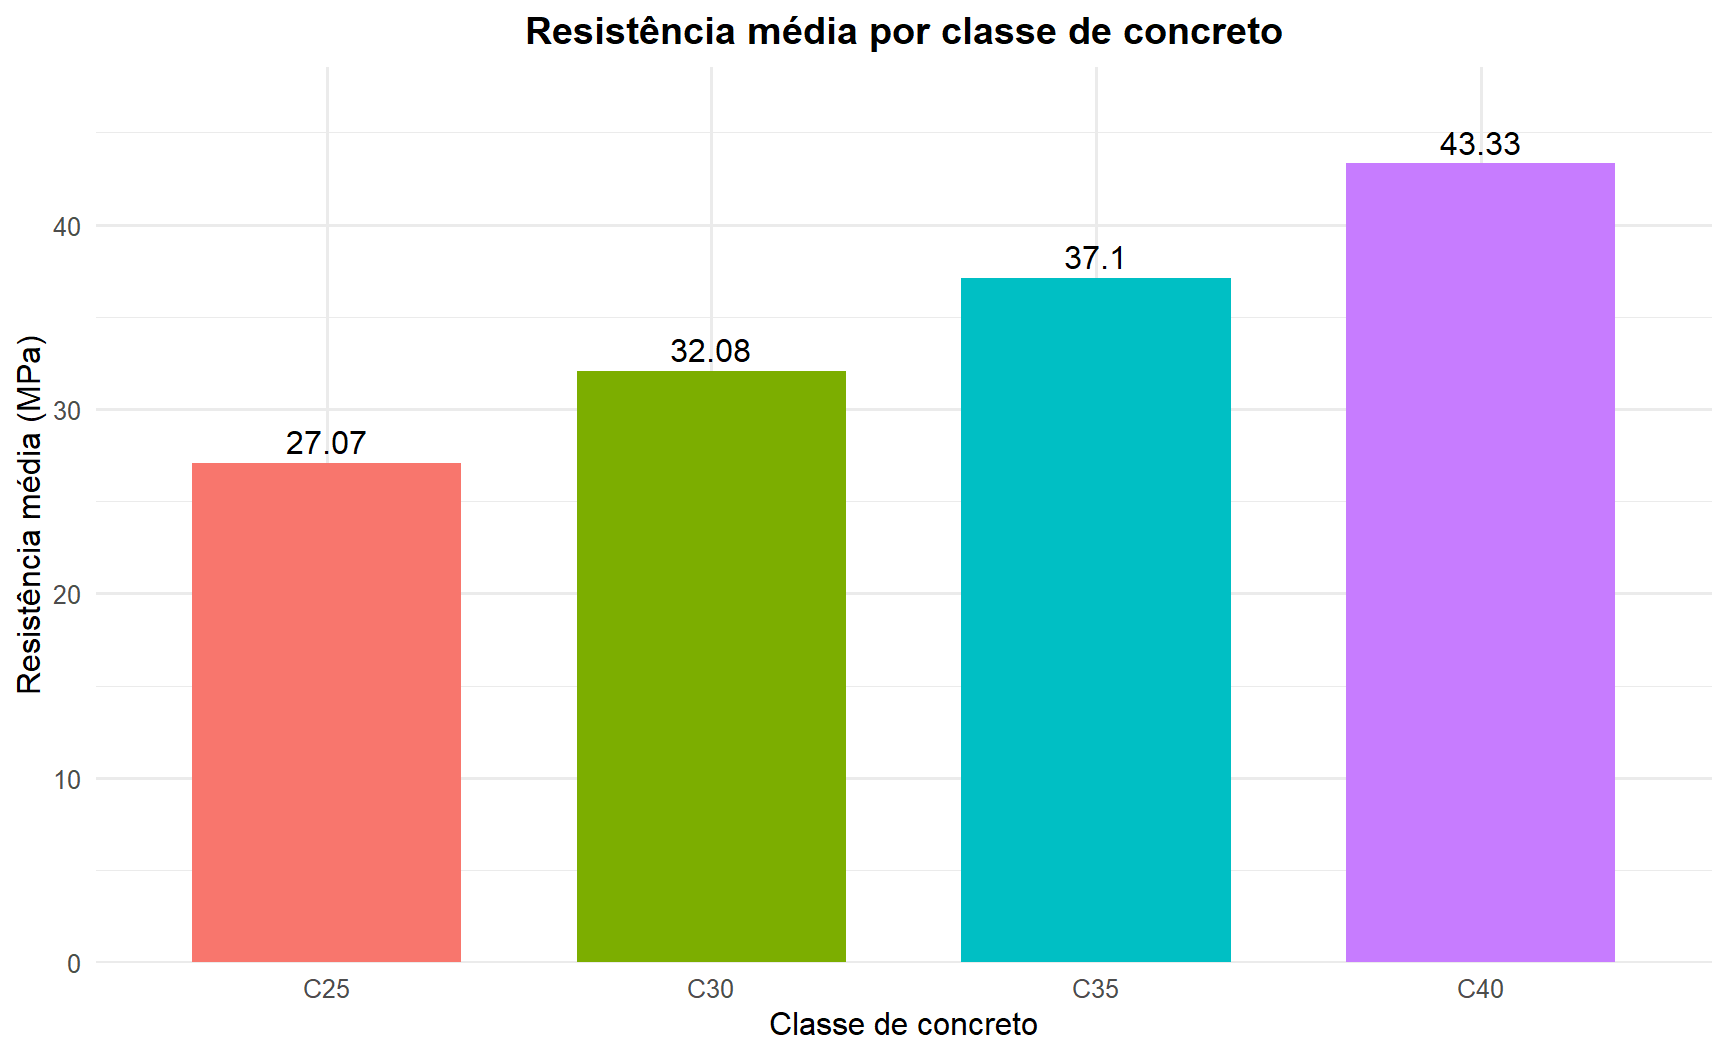
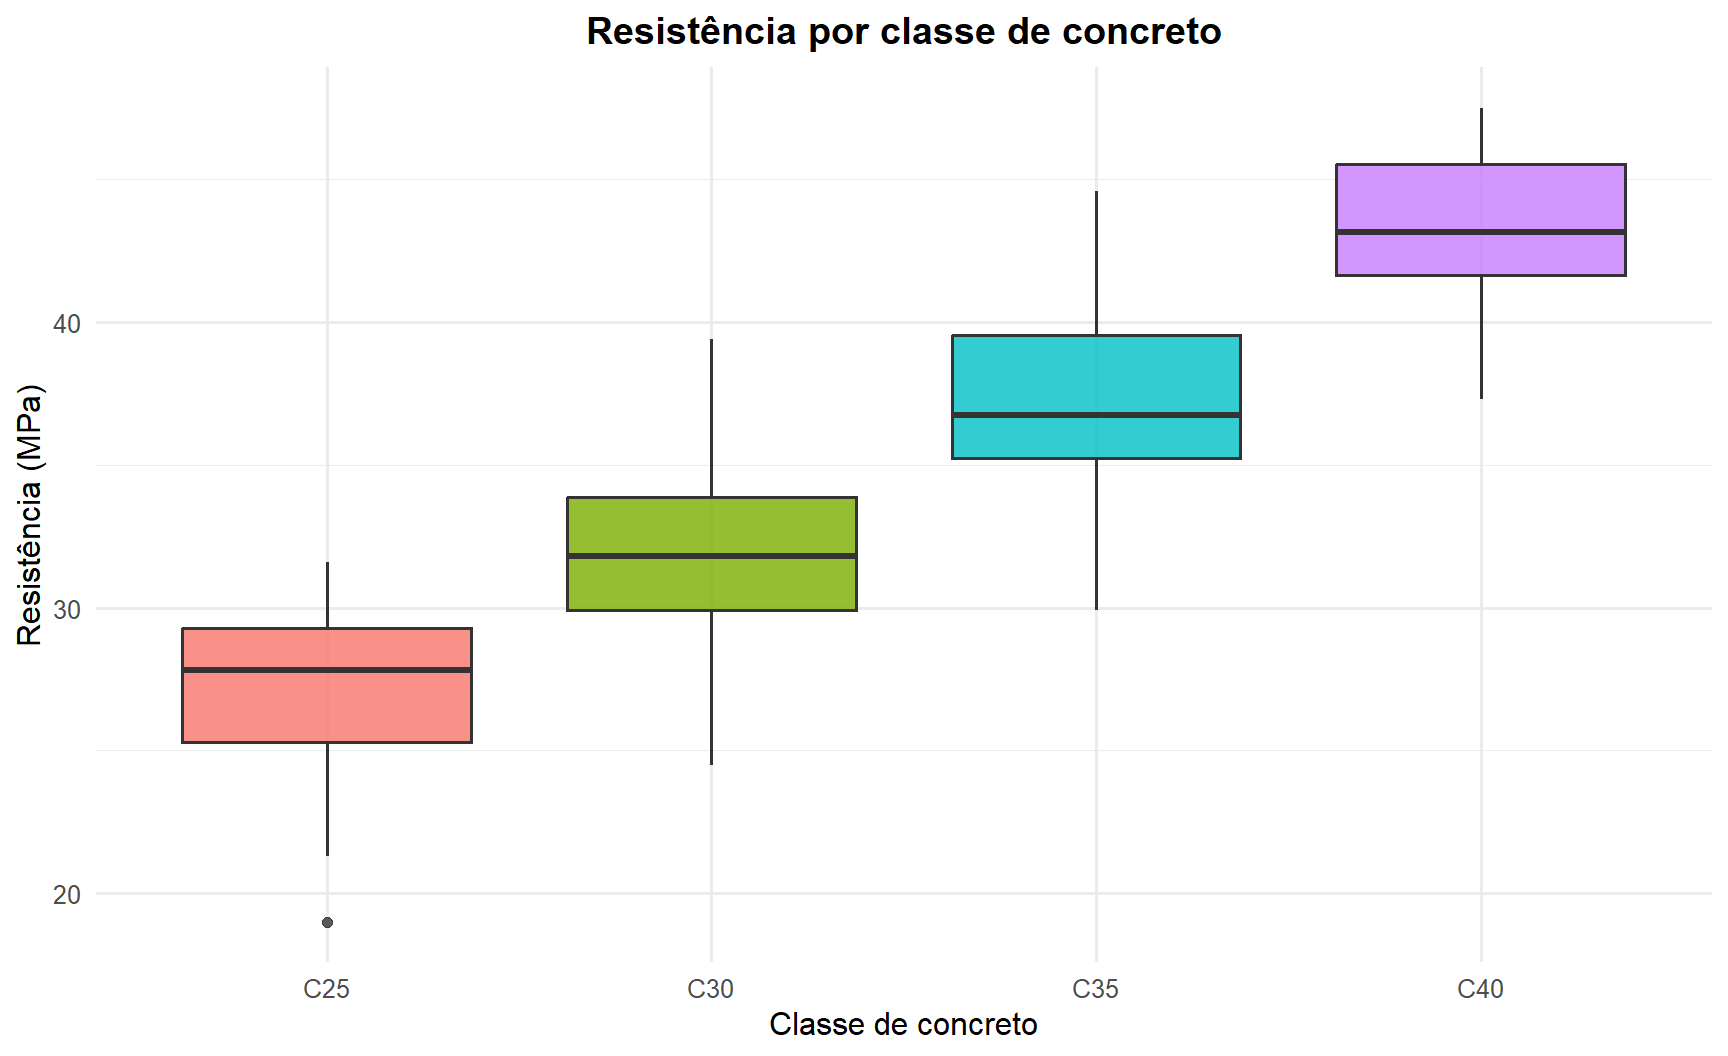
A resistência média aumenta consistentemente com a classe do concreto, como esperado pela especificação técnica da @ABNT6118:2014. A classe C40 apresentou a maior resistência média (43,33 MPa), enquanto a C25 apresentou a menor (27,07 MPa). É importante notar que a resistência média de cada classe supera o valor característico de referência, o que indica bom desempenho geral.
```{r}
#| label: fig-media-tipo
#| fig-cap: "Resistência média por classe de concreto"
ggplot(resumo_por_tipo, aes(x = tipo_concreto, y = media_mpa, fill = tipo_concreto)) +
  geom_col(width = 0.7, show.legend = FALSE) +
  geom_text(aes(label = round(media_mpa, 2)), vjust = -0.4) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(
    title = "Resistência média por classe de concreto",
    x = "Classe de concreto",
    y = "Resistência média (MPa)"
  ) +
  tema_relatorio
```
### Resistência por idade
```{r}
#| label: tab-resistencia-idade
#| tbl-cap: "Resistência média por idade de ensaio"
resumo_por_idade <- dados_limpos |>
  group_by(idade_dias) |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    media_mpa = mean(resistencia_mpa, na.rm = TRUE),
    desvio_padrao_mpa = sd(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(idade_dias)

kable(resumo_por_idade, digits = 2, align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
```{r}
#| label: fig-media-idade
#| fig-cap: "Resistência média por idade do corpo de prova"
ggplot(resumo_por_idade, aes(x = factor(idade_dias), y = media_mpa)) +
  geom_col(fill = "#2E86C1", width = 0.7) +
  geom_text(aes(label = round(media_mpa, 2)), vjust = -0.4) +
  scale_y_continuous(expand = expansion(mult = c(0, 0.12))) +
  labs(
    title = "Resistência média por idade",
    x = "Idade (dias)",
    y = "Resistência média (MPa)"
  ) +
  tema_relatorio
```
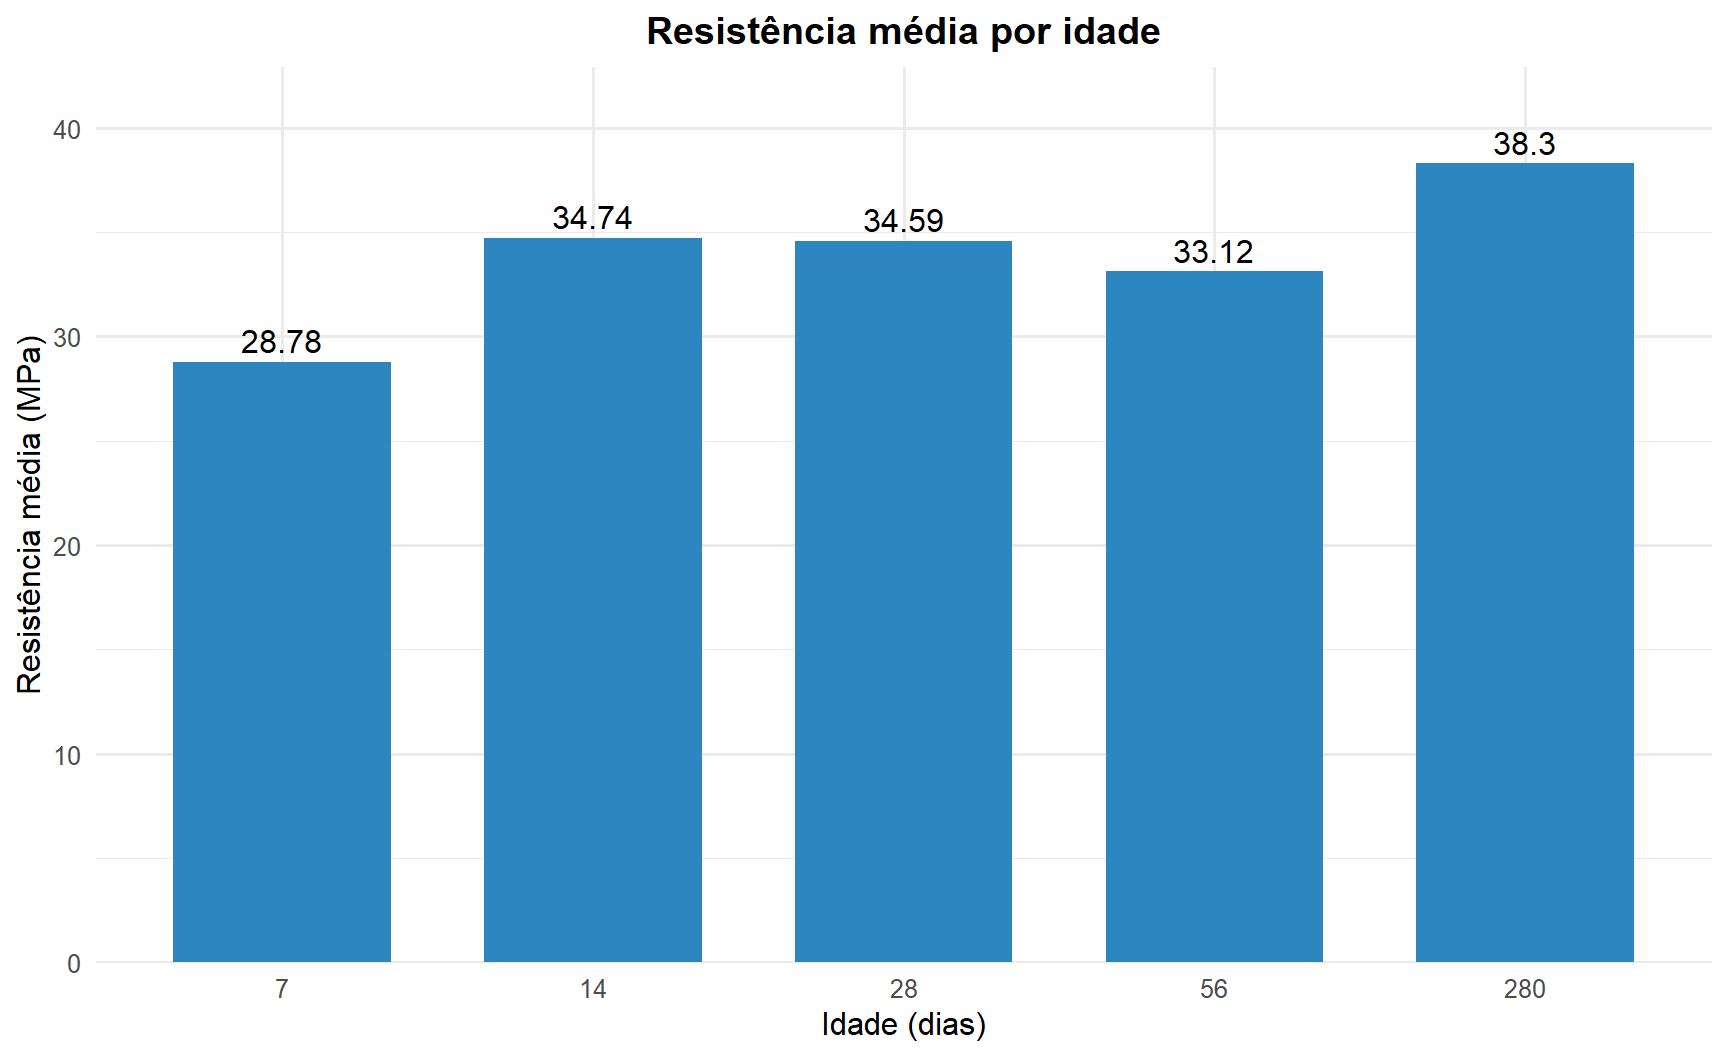
As médias por idade devem ser interpretadas com cuidado, pois os grupos podem conter diferentes classes de concreto e tamanhos amostrais distintos. Uma diferença entre idades não representa necessariamente apenas o efeito do tempo de cura.
### Médias de múltiplas variáveis por tipo
```{r}
#| label: tab-medias-multiplas
#| tbl-cap: "Médias das propriedades por classe de concreto"
medias_multiplas_tipo <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    across(
      c(
        resistencia_mpa,
        cimento_kg_m3,
        relacao_a_c,
        abatimento_mm,
        densidade_kg_m3,
        absorcao_agregado_pct
      ),
      ~ mean(.x, na.rm = TRUE)
    ),
    .groups = "drop"
  )

kable(medias_multiplas_tipo, digits = 2, align = "c") |>
  kable_styling(full_width = FALSE, position = "center") |>
  scroll_box(width = "100%")
```
Essa solução substitui aggregate(cbind(...) ~ grupo, ...). O uso de across() facilita incluir ou remover variáveis e aplicar mais de uma estatística, mantendo o agrupamento explícito.
## Criação de variáveis derivadas
Serão criadas quatro variáveis derivadas:
- fck_referencia: resistência característica indicada pela classe;
- resistencia_relativa: razão entre resistência observada e referência;
- classificacao: categoria de desempenho relativo;
- acima_media_classe: comparação de cada ensaio com a média de sua classe.
```{r}
#| label: variaveis-derivadas
dados_limpos <- dados_limpos |>
  mutate(
    fck_referencia = case_when(
      tipo_concreto == "C25" ~ 25,
      tipo_concreto == "C30" ~ 30,
      tipo_concreto == "C35" ~ 35,
      tipo_concreto == "C40" ~ 40,
      TRUE ~ NA_real_
    ),
    resistencia_relativa = resistencia_mpa / fck_referencia,
    classificacao = case_when(
      is.na(resistencia_relativa) ~ NA_character_,
      resistencia_relativa >= 1.10 ~ "Excelente",
      resistencia_relativa >= 0.95 ~ "Bom",
      resistencia_relativa >= 0.85 ~ "Regular",
      TRUE ~ "Insatisfatório"
    )
  ) |>
  group_by(tipo_concreto) |>
  mutate(
    media_classe = mean(resistencia_mpa, na.rm = TRUE),
    acima_media_classe = case_when(
      is.na(resistencia_mpa) ~ NA,
      TRUE ~ resistencia_mpa > media_classe
    )
  ) |>
  ungroup()
```
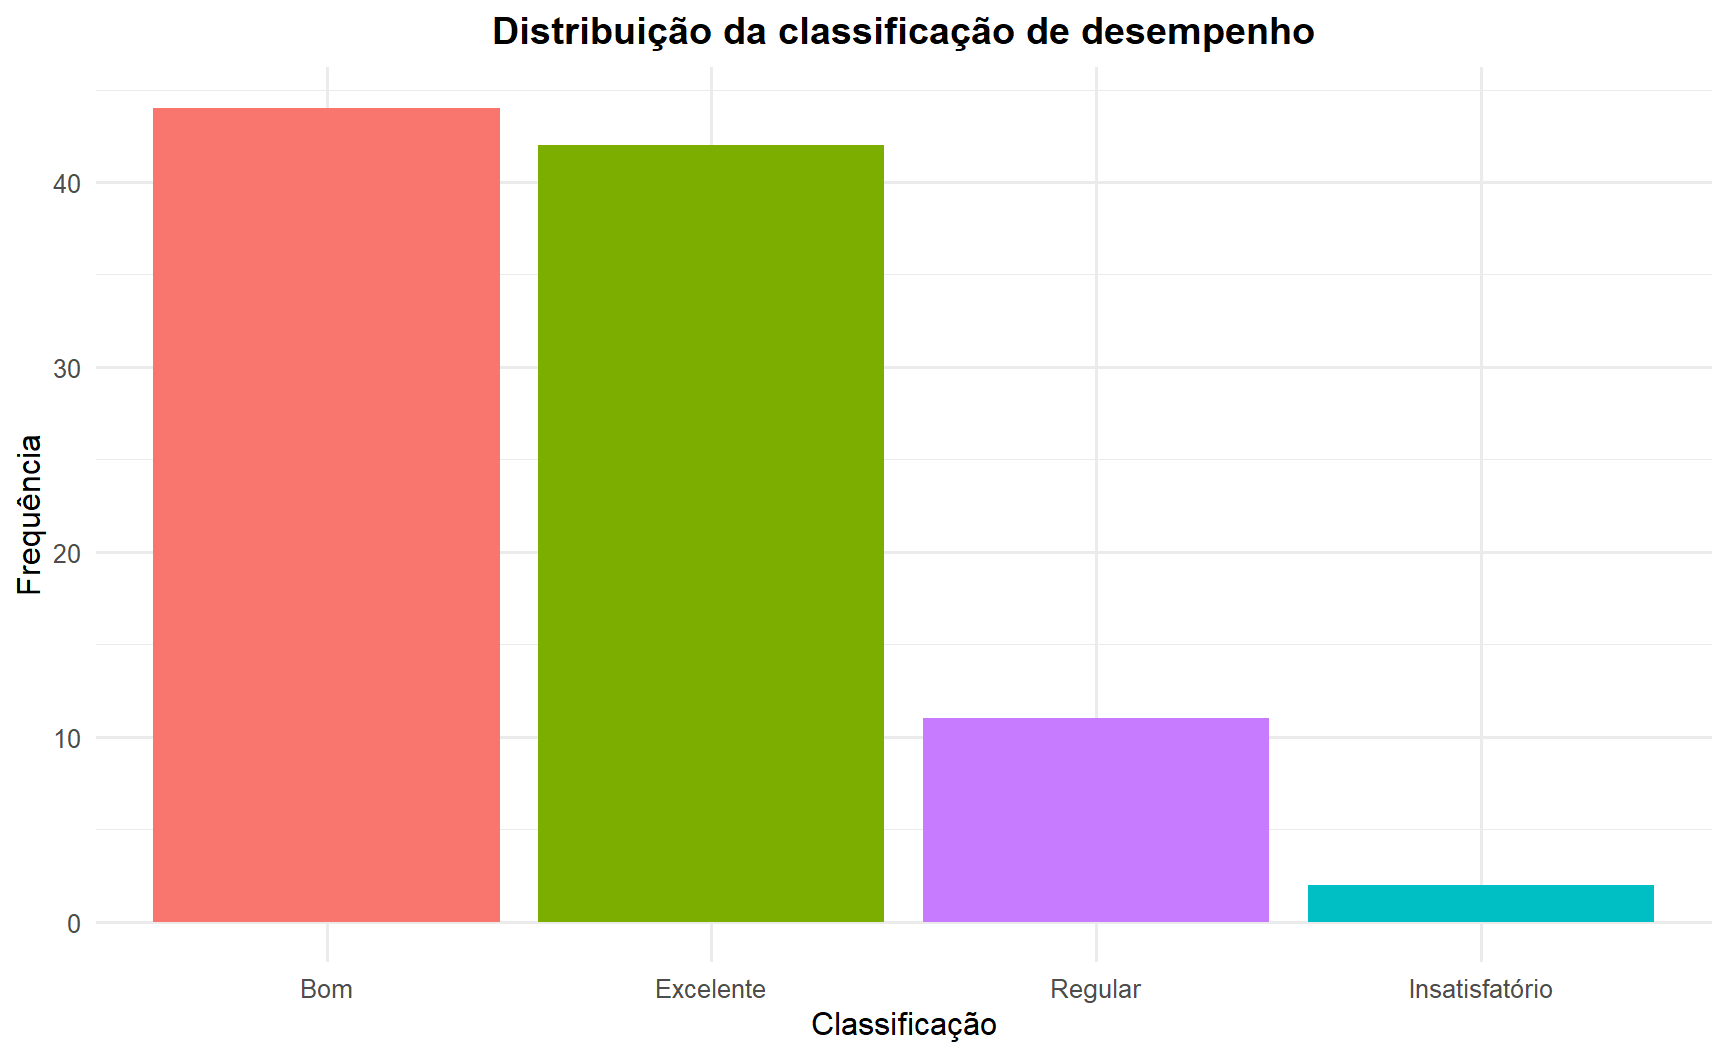
Na Base R, a resistência relativa era criada com atribuição por $, a classificação com ifelse() aninhado e a média da classe com ave(). No Tidyverse, mutate() reúne a criação das variáveis, case_when() organiza as regras e group_by() permite calcular valores dentro de cada classe.
### Distribuição da classificação
```{r}
#| label: tab-classificacao
#| tbl-cap: "Distribuição da classificação de desempenho"
resumo_classificacao <- dados_limpos |>
  count(classificacao, name = "frequencia") |>
  mutate(
    classificacao = replace_na(classificacao, "Ausente"),
    percentual = 100 * frequencia / sum(frequencia)
  ) |>
  arrange(desc(frequencia))

kable(resumo_classificacao, digits = 1, align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
```{r}
#| label: fig-classificacao
#| fig-cap: "Classificação do desempenho relativo dos corpos de prova"
ggplot(
  resumo_classificacao |> filter(classificacao != "Ausente"),
  aes(x = reorder(classificacao, -frequencia), y = frequencia, fill = classificacao)
) +
  geom_col(show.legend = FALSE) +
  labs(
    title = "Distribuição da classificação de desempenho",
    x = "Classificação",
    y = "Frequência"
  ) +
  tema_relatorio
```
### Proporção acima da média da classe
```{r}
#| label: tab-acima-media
#| tbl-cap: "Corpos de prova acima da média de sua classe"
resumo_acima_media <- dados_limpos |>
  count(acima_media_classe, name = "frequencia") |>
  mutate(
    situacao = case_when(
      is.na(acima_media_classe) ~ "Resistência ausente",
      acima_media_classe ~ "Acima da média",
      TRUE ~ "Na média ou abaixo"
    ),
    percentual = 100 * frequencia / sum(frequencia)
  ) |>
  select(situacao, frequencia, percentual)

kable(resumo_acima_media, digits = 1, align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
## Visualização exploratória
### Histograma da resistência
```{r}
#| label: fig-histograma
#| fig-cap: "Distribuição da resistência à compressão"
ggplot(dados_limpos, aes(x = resistencia_mpa)) +
  geom_histogram(bins = 15, fill = "#2E86C1", color = "white", na.rm = TRUE) +
  labs(
    title = "Distribuição da resistência à compressão",
    x = "Resistência (MPa)",
    y = "Frequência"
  ) +
  tema_relatorio
```
### Boxplot por classe
```{r}
#| label: fig-boxplot-tipo
#| fig-cap: "Distribuição da resistência por classe de concreto"
ggplot(dados_limpos, aes(x = tipo_concreto, y = resistencia_mpa, fill = tipo_concreto)) +
  geom_boxplot(alpha = 0.8, na.rm = TRUE, show.legend = FALSE) +
  labs(
    title = "Resistência por classe de concreto",
    x = "Classe de concreto",
    y = "Resistência (MPa)"
  ) +
  tema_relatorio
```
## Relações entre variáveis
### Consumo de cimento e resistência
```{r}
#| label: tab-cor-cimento
#| tbl-cap: "Correlação entre consumo de cimento e resistência"
cor_cimento <- dados_limpos |>
  drop_na(cimento_kg_m3, resistencia_mpa) |>
  summarise(
    n = n(),
    correlacao_pearson = cor(cimento_kg_m3, resistencia_mpa)
  )

kable(cor_cimento, digits = 4, align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
```{r}
#| label: fig-cimento-resistencia
#| fig-cap: "Relação entre consumo de cimento e resistência"
ggplot(dados_limpos, aes(x = cimento_kg_m3, y = resistencia_mpa, color = tipo_concreto)) +
  geom_point(size = 2.4, alpha = 0.8, na.rm = TRUE) +
  geom_smooth(method = "lm", se = TRUE, color = "black", na.rm = TRUE) +
  labs(
    title = "Consumo de cimento versus resistência",
    x = "Consumo de cimento (kg/m³)",
    y = "Resistência (MPa)",
    color = "Classe"
  ) +
  tema_relatorio
```
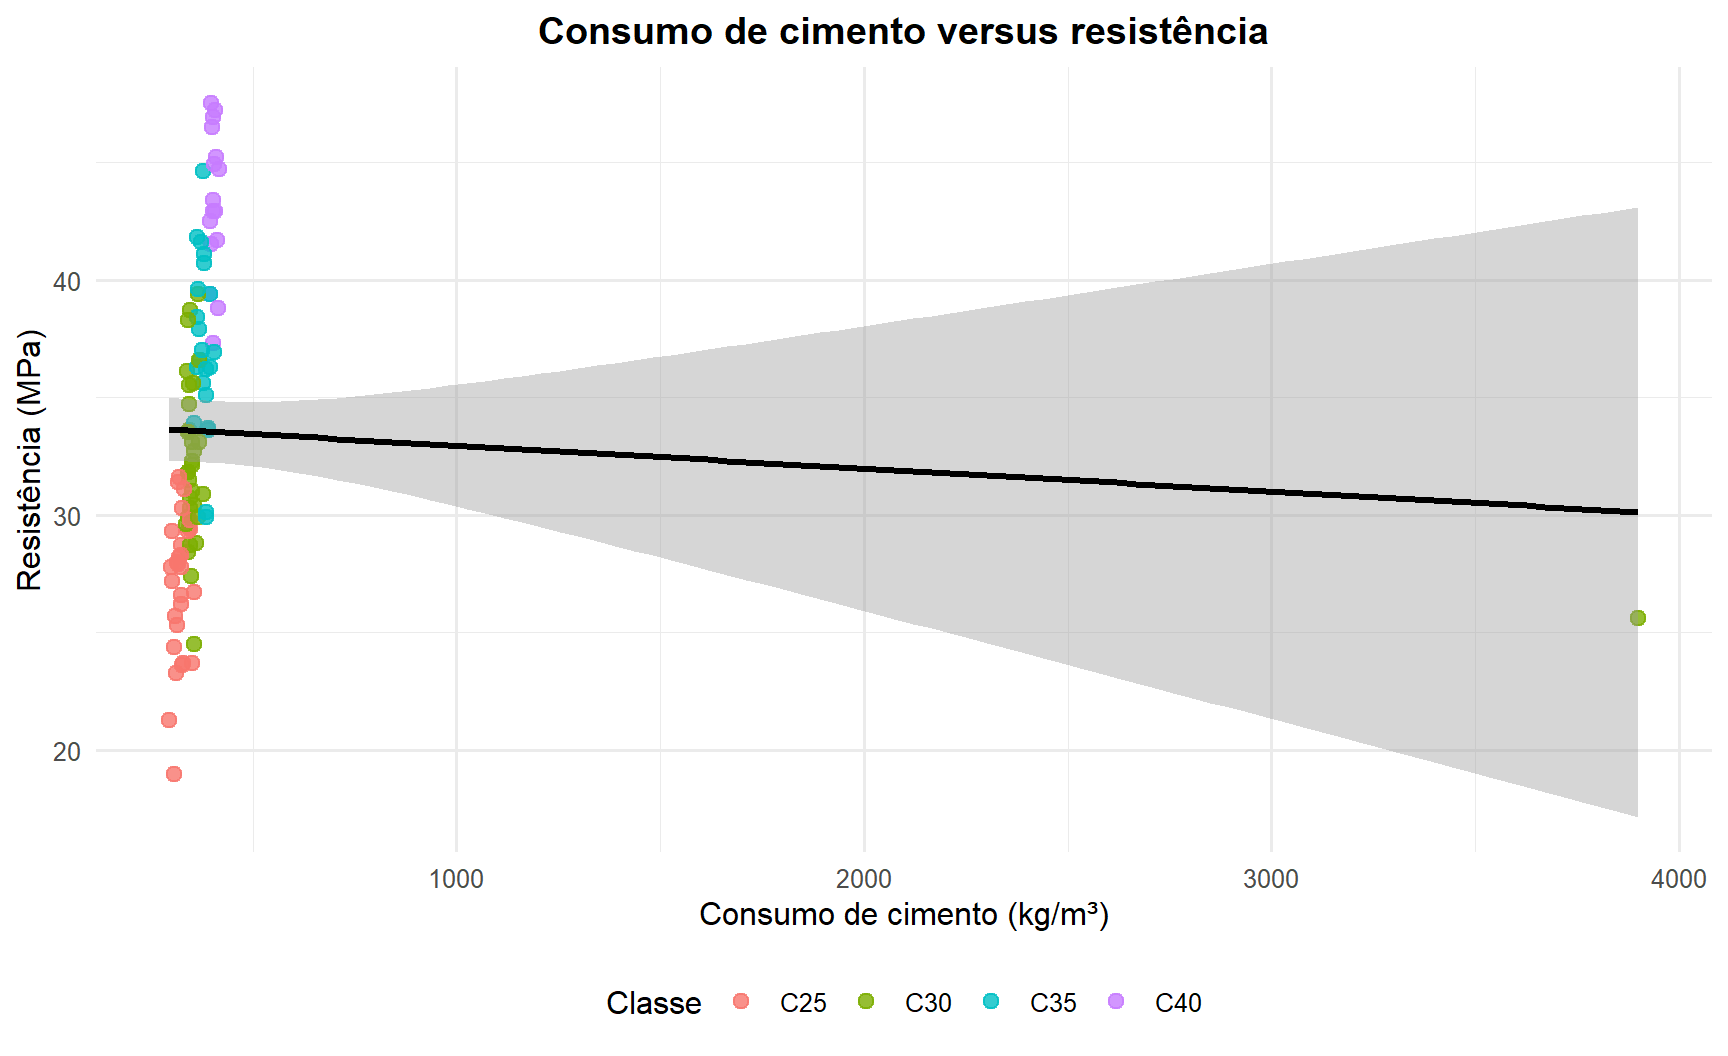
A correlação simples deve ser interpretada com cautela. O consumo de cimento não atua isoladamente, pois resistência, relação água/cimento, idade, cura, adensamento e materiais estão relacionados.
### Relação água/cimento e resistência
```{r}
#| label: tab-cor-ac
#| tbl-cap: "Correlação entre relação água/cimento e resistência"
cor_ac <- dados_limpos |>
  drop_na(relacao_a_c, resistencia_mpa) |>
  summarise(
    n = n(),
    correlacao_pearson = cor(relacao_a_c, resistencia_mpa)
  )

kable(cor_ac, digits = 4, align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
```{r}
#| label: fig-ac-resistencia
#| fig-cap: "Relação água/cimento versus resistência"
ggplot(dados_limpos, aes(x = relacao_a_c, y = resistencia_mpa, color = tipo_concreto)) +
  geom_point(size = 2.4, alpha = 0.8, na.rm = TRUE) +
  geom_smooth(method = "lm", se = TRUE, color = "black", na.rm = TRUE) +
  labs(
    title = "Relação água/cimento versus resistência",
    x = "Relação água/cimento",
    y = "Resistência (MPa)",
    color = "Classe"
  ) +
  tema_relatorio
```
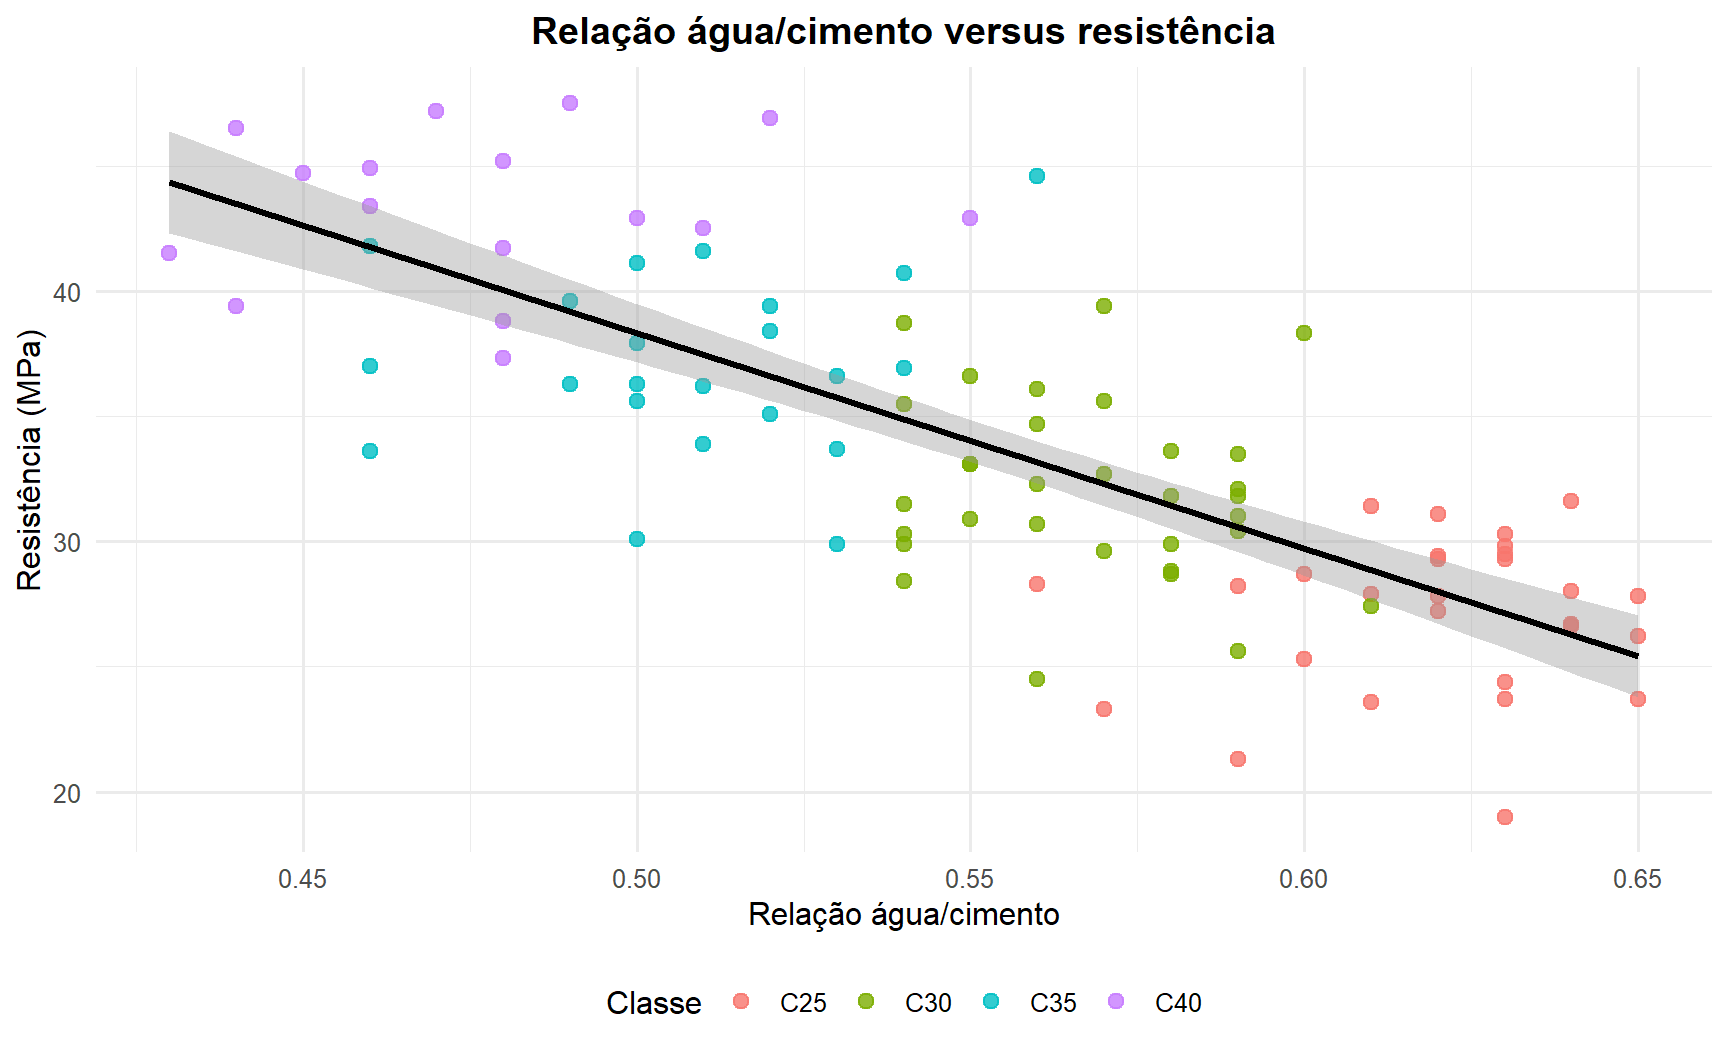
Uma correlação negativa indica que, na amostra, maiores relações água/cimento tendem a estar associadas a menores resistências. Entretanto, correlação não demonstra causalidade isolada e pode refletir simultaneamente as classes de concreto presentes na base.
### Matriz de correlação em formato longo
```{r}
#| label: tab-matriz-correlacao
#| tbl-cap: "Matriz de correlação das variáveis selecionadas"
variaveis_correlacao <- dados_limpos |>
  select(
    resistencia_mpa,
    cimento_kg_m3,
    relacao_a_c,
    idade_dias,
    abatimento_mm,
    densidade_kg_m3,
    absorcao_agregado_pct
  )

matriz_correlacao <- variaveis_correlacao |>
  cor(use = "pairwise.complete.obs") |>
  as_tibble(rownames = "Variavel")

kable(matriz_correlacao, digits = 3, align = "c") |>
  kable_styling(full_width = FALSE, position = "center") |>
  scroll_box(width = "100%")
```
A seleção das variáveis é realizada com select(). A função estatística cor() continua necessária, pois o Tidyverse organiza e prepara os dados, mas não substitui os fundamentos estatísticos do R.
## Avaliação da afirmação sobre o Bloco C
A afirmação de que o Bloco C apresenta desempenho superior deve ser comparada às médias observadas, mas também exige considerar a composição das classes e idades em cada obra.
```{r}
#| label: tab-comparacao-bloco-c
#| tbl-cap: "Comparação da resistência média entre as obras"
comparacao_blocos <- resumo_por_obra |>
  mutate(
    posicao = row_number(),
    bloco_c = if_else(obra == "Bloco C", "Bloco analisado", "Demais blocos")
  )

kable(comparacao_blocos, digits = 2, align = "c") |>
  kable_styling(full_width = FALSE, position = "center")
```
A conclusão deve ser extraída da tabela calculada no momento da renderização. Uma média bruta inferior para o Bloco C não sustenta a afirmação de superioridade. Contudo, uma comparação mais rigorosa deveria controlar classe de concreto, idade e demais condições de produção.
## Informações estratégicas para o engenheiro
### Conformidade descritiva por classe
A comparação abaixo é exploratória e individual. A aceitação normativa de lotes não deve ser baseada apenas na proporção de resultados individuais acima do fck.
```{r}
#| label: tab-conformidade
#| tbl-cap: "Desempenho descritivo em relação ao valor de referência da classe"
conformidade_classe <- dados_limpos |>
  group_by(tipo_concreto, fck_referencia) |>
  summarise(
    n_validos = sum(!is.na(resistencia_mpa)),
    resistencia_media_mpa = mean(resistencia_mpa, na.rm = TRUE),
    desvio_padrao_mpa = sd(resistencia_mpa, na.rm = TRUE),
    cv_pct = 100 * desvio_padrao_mpa / resistencia_media_mpa,
    n_abaixo_referencia = sum(resistencia_mpa < fck_referencia, na.rm = TRUE),
    pct_abaixo_referencia = 100 * n_abaixo_referencia / n_validos,
    .groups = "drop"
  ) |>
  arrange(tipo_concreto)

kable(conformidade_classe, digits = 2, align = "c") |>
  kable_styling(full_width = FALSE, position = "center") |>
  scroll_box(width = "100%")
```
### Corpos de prova prioritários para investigação
```{r}
#| label: tab-prioridades
#| tbl-cap: "Corpos de prova prioritários para investigação"
prioridades <- dados_limpos |>
  mutate(
    prioridade = case_when(
      is.na(resistencia_mpa) ~ "Resistência ausente",
      resistencia_mpa < fck_referencia ~ "Resistência abaixo da referência",
      abatimento_mm > 300 ~ "Abatimento suspeito",
      densidade_kg_m3 < 1000 ~ "Densidade suspeita",
      absorcao_agregado_pct > 4 ~ "Absorção suspeita",
      idade_dias > 100 ~ "Idade atípica",
      TRUE ~ NA_character_
    )
  ) |>
  filter(!is.na(prioridade)) |>
  select(
    id_corpo_prova, obra, tipo_concreto, idade_dias,
    resistencia_mpa, fck_referencia, prioridade
  ) |>
  arrange(prioridade, id_corpo_prova)

kable(prioridades, align = "c") |>
  kable_styling(full_width = FALSE, position = "center") |>
  scroll_box(width = "100%", height = "400px")
```
### Resumo executivo calculado automaticamente
```{r}
#| label: resumo-executivo
indicadores_gerais <- dados_limpos |>
  summarise(
    resistencia_media_geral = mean(resistencia_mpa, na.rm = TRUE),
    percentual_excelente = 100 * mean(classificacao == "Excelente", na.rm = TRUE),
    percentual_bom_ou_excelente = 100 * mean(
      classificacao %in% c("Excelente", "Bom"),
      na.rm = TRUE
    )
  )

melhor_bloco <- resumo_por_obra |>
  slice_max(media_mpa, n = 1, with_ties = FALSE)

maior_classe <- resumo_por_tipo |>
  slice_max(media_mpa, n = 1, with_ties = FALSE)

resumo_executivo <- tibble(
  Indicador = c(
    "Resistência média geral",
    "Obra com maior resistência média",
    "Classe com maior resistência média",
    "Corpos de prova classificados como Excelente",
    "Corpos de prova classificados como Bom ou Excelente",
    "Correlação entre a/c e resistência"
  ),
  Resultado = c(
    paste0(round(indicadores_gerais$resistencia_media_geral, 2), " MPa"),
    paste0(melhor_bloco$obra, " (", round(melhor_bloco$media_mpa, 2), " MPa)"),
    paste0(maior_classe$tipo_concreto, " (", round(maior_classe$media_mpa, 2), " MPa)"),
    paste0(round(indicadores_gerais$percentual_excelente, 1), "%"),
    paste0(round(indicadores_gerais$percentual_bom_ou_excelente, 1), "%"),
    round(cor_ac$correlacao_pearson, 3)
  )
)

kable(resumo_executivo, align = c("l", "c")) |>
  kable_styling(
    bootstrap_options = c("striped", "hover"),
    full_width = FALSE,
    position = "center"
  )
```
## Verificação final
```{r}
#| label: verificacao-final
glimpse(dados_limpos)
```
```{r}
#| label: tab-verificacao-final
#| tbl-cap: "Verificação final da base processada"
verificacao_final <- tibble(
  Verificacao = c(
    "Número de observações",
    "Número de variáveis após derivação",
    "Categorias de obra",
    "Categorias de tipo de concreto",
    "Valores ausentes totais"
  ),
  Resultado = c(
    as.character(nrow(dados_limpos)),
    as.character(ncol(dados_limpos)),
    as.character(n_distinct(dados_limpos$obra)),
    as.character(n_distinct(dados_limpos$tipo_concreto)),
    as.character(sum(is.na(dados_limpos)))
  )
)

kable(verificacao_final, align = c("l", "c")) |>
  kable_styling(full_width = FALSE, position = "center")
```
# 🧩 Script consolidado do desafio
O bloco abaixo reúne a lógica essencial em um único fluxo reproduzível. Ele pode ser utilizado como versão resumida da solução.
```r
#| label: script-consolidado
#| eval: false

library(tidyverse)

converter_numero <- function(x) {
  x |>
    str_trim() |>
    str_replace_all("[Oo]", "0") |>
    str_replace_all(",", ".") |>
    parse_double(locale = locale(decimal_mark = "."))
}

dados <- read_delim(
  "base_processamento_dados_engenharia_civil.csv",
  delim = ";",
  na = c("", " ", "NA", "N/A", "-", "null", "NULL"),
  col_types = cols(.default = col_character()),
  trim_ws = FALSE,
  show_col_types = FALSE
)

# Diagnóstico inicial
dados |> glimpse()

dados |>
  summarise(across(everything(), ~ sum(is.na(.x))))

dados |> count(obra)
dados |> count(tipo_concreto)

dados |>
  filter(obra != str_trim(obra))

# Limpeza sem alterar o objeto original
dados_limpos <- dados |>
  rename(absorcao_agregado_pct = `absorção_agregado_pct`) |>
  mutate(
    id_corpo_prova = str_trim(id_corpo_prova),
    obra = str_trim(obra),
    tipo_concreto = str_to_upper(str_trim(tipo_concreto)),
    idade_dias = parse_integer(str_trim(idade_dias)),
    across(
      c(
        resistencia_mpa, cimento_kg_m3, relacao_a_c,
        abatimento_mm, densidade_kg_m3, absorcao_agregado_pct
      ),
      converter_numero
    ),
    fck_referencia = case_when(
      tipo_concreto == "C25" ~ 25,
      tipo_concreto == "C30" ~ 30,
      tipo_concreto == "C35" ~ 35,
      tipo_concreto == "C40" ~ 40,
      TRUE ~ NA_real_
    ),
    resistencia_relativa = resistencia_mpa / fck_referencia,
    classificacao = case_when(
      is.na(resistencia_relativa) ~ NA_character_,
      resistencia_relativa >= 1.10 ~ "Excelente",
      resistencia_relativa >= 0.95 ~ "Bom",
      resistencia_relativa >= 0.85 ~ "Regular",
      TRUE ~ "Insatisfatório"
    )
  ) |>
  group_by(tipo_concreto) |>
  mutate(
    media_classe = mean(resistencia_mpa, na.rm = TRUE),
    acima_media_classe = resistencia_mpa > media_classe
  ) |>
  ungroup()

# Estatísticas gerais
dados_limpos |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    media = mean(resistencia_mpa, na.rm = TRUE),
    mediana = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
    minimo = min(resistencia_mpa, na.rm = TRUE),
    maximo = max(resistencia_mpa, na.rm = TRUE)
  )

# Estatísticas por classe
dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    n = sum(!is.na(resistencia_mpa)),
    media = mean(resistencia_mpa, na.rm = TRUE),
    mediana = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  )

# Estatísticas por obra
dados_limpos |>
  group_by(obra) |>
  summarise(
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    n = sum(!is.na(resistencia_mpa)),
    .groups = "drop"
  ) |>
  arrange(desc(resistencia_media))

# Correlações relevantes
dados_limpos |>
  select(resistencia_mpa, cimento_kg_m3, relacao_a_c, idade_dias, abatimento_mm) |>
  cor(use = "pairwise.complete.obs")

# Gráfico principal
ggplot(dados_limpos, aes(relacao_a_c, resistencia_mpa, color = tipo_concreto)) +
  geom_point() +
  geom_smooth(method = "lm", se = TRUE, color = "black") +
  theme_minimal()
```
# 🧠 Considerações finais
A aplicação do Tidyverse permitiu organizar o processamento em uma sequência clara: importação, diagnóstico, padronização, conversão, investigação, criação de variáveis, agrupamento, resumo e visualização. Os dados brutos foram preservados, e a base limpa foi criada em um objeto independente.
A principal mudança em relação ao Base R não está apenas nos nomes das funções, mas na lógica de organização. Em vez de executar operações isoladas e armazenar diversos objetos intermediários, o Tidyverse favorece fluxos encadeados, nos quais cada etapa recebe o resultado da etapa anterior.
O diagnóstico confirmou a necessidade de tratar representações numéricas inconsistentes, padronizar categorias e registrar valores ausentes. Também foram identificados registros que exigem investigação técnica.
A análise demonstra que uma ferramenta de programação pode facilitar o tratamento, mas não decide sozinha se um valor é erro, condição especial do material ou observação válida. Essa decisão depende da integração entre estatística, rastreabilidade e conhecimento de Engenharia Civil.
# 📝 Reflexão Final
## Qual é a principal diferença entre resolver um problema de processamento de dados utilizando Base R e utilizando as ferramentas da família tidyverse?
A principal diferença está na filosofia de organização do código. No Base R, as operações são geralmente executadas de forma isolada, com funções como tapply(), aggregate() e apply() que resolvem tarefas específicas, mas frequentemente exigem a criação de objetos intermediários e o aninhamento de funções. O código tende a ser mais fragmentado e menos intuitivo para quem não está familiarizado com a sintaxe.
No Tidyverse, a análise é organizada como um fluxo contínuo utilizando o operador |>. Os verbos do dplyr (filter(), mutate(), summarise(), group_by()) descrevem explicitamente cada ação realizada, e o encadeamento permite ler o código de cima para baixo, seguindo a ordem lógica do processamento. Isso torna o código mais legível, modular e fácil de auditar.
## Por que o processamento e a limpeza dos dados são etapas fundamentais antes da aplicação de métodos estatísticos na Engenharia Civil?
O processamento e a limpeza de dados são fundamentais por diversas razões:
- Garantia da confiabilidade dos resultados: Erros de digitação como "3O,4" em vez de "30,4" ou "0,55" em vez de "0,55" podem levar a conclusões equivocadas sobre o desempenho do concreto. Uma estrutura projetada com base em dados incorretos pode estar subdimensionada, comprometendo a segurança estrutural.
- Permissão de cálculos estatísticos válidos: Variáveis lidas como texto não permitem o cálculo de médias, desvios, correlações ou testes de hipótese. Sem a conversão adequada, análises essenciais para o controle tecnológico se tornam impossíveis.
- Garantia de comparabilidade e consistência: Categorias não padronizadas ("c30" vs "C30", "Bloco B " vs "Bloco B") criam grupos artificiais que distorcem a análise por grupos, levando a conclusões incorretas sobre o desempenho de diferentes obras ou classes de concreto.
- Prevenção de decisões técnicas erradas: Um valor de resistência incorreto pode levar a aceitar um lote que deveria ser rejeitado (comprometendo a segurança estrutural) ou rejeitar um lote aceitável (gerando desperdício financeiro e atrasos na obra).
- Base para decisões de projeto e normativas: Em Engenharia Civil, as decisões são frequentemente baseadas em valores característicos e estatísticas de amostras, conforme estabelecido por normas como a ABNT NBR 12655 e NBR 6118. A confiabilidade dessas estimativas depende diretamente da qualidade dos dados de entrada.
## Descreva brevemente: qual foi o principal problema encontrado na base; qual decisão você tomou para tratá-lo; quais funções do tidyverse foram utilizadas; por que você considera que sua solução é adequada.
**Principal problema encontrado:**
A inconsistência generalizada de tipos de dados, onde variáveis quantitativas essenciais para o controle tecnológico do concreto foram importadas como texto (character) devido a erros de digitação sistemáticos:
- Substituição do número zero (0) pela letra "O" maiúscula em valores numéricos (ex: "3O,4" no CP-019, "390O" no CP-064);
- Uso de vírgula como separador decimal em um sistema configurado para ponto decimal (ex: "38,7" no CP-008, "0,55" no CP-045);
- Espaços extras em categorias textuais ("Bloco B " em vez de "Bloco B");
- Diferenças de maiúsculas/minúsculas em variáveis categóricas ("c30" em vez de "C30").
**Decisão adotada:**
A limpeza sistemática com substituição de caracteres problemáticos e conversão de tipos, preservando a base original em um objeto separado (dados_limpos). Para os valores ausentes, optou-se por mantê-los, utilizando na.rm = TRUE nos cálculos, pois a imputação poderia introduzir viés, especialmente na variável resposta (resistência). Os valores suspeitos (abatimento 1250 mm, densidade 238 kg/m³) foram sinalizados para investigação, mas não corrigidos automaticamente.
**Funções do Tidyverse utilizadas:**
```{r}
#| label: tab-funcoes-tidyverse
#| tbl-cap: "Funções do Tidyverse utilizadas no processamento"
library(tibble)
library(knitr)
library(kableExtra)

# Criando a tabela com as funções
tabela_funcoes <- tribble(
  ~Etapa, ~Funções,
  "Importação", "`read_csv2()`",
  "Padronização textual", "`str_trim()`, `str_to_upper()`, `str_replace_all()`",
  "Conversão numérica", "`parse_double()`, `parse_integer()`",
  "Limpeza e transformação", "`mutate()`, `across()`, `rename()`",
  "Diagnóstico", "`glimpse()`, `count()`, `distinct()`, `filter()`",
  "Agrupamento e resumo", "`group_by()`, `summarise()`",
  "Criação de variáveis", "`case_when()`, `if_else()`",
  "Visualização", "`ggplot()`, `geom_boxplot()`, `geom_point()`, `geom_col()`"
)

# Número de colunas (para aplicar centralização em todas)
n_col <- ncol(tabela_funcoes)

kable(tabela_funcoes,
      booktabs = TRUE,
      align = c("l", "l")) |>  # alinhamento à esquerda para melhor leitura
  kable_styling(bootstrap_options = c("striped", "hover", "condensed"),
                full_width = FALSE,
                position = "center") |>
  column_spec(1, bold = TRUE, color = "#0056b3") |>  # destaca a primeira coluna
  column_spec(2, color = "#6C757D") |>  # funções em cinza
  row_spec(0, bold = TRUE, background = "#F8F9FA") |>  # cabeçalho
  scroll_box(width = "100%", height = "400px")
```
**Por que a solução é adequada:**
A solução é adequada porque:
- Preserva a rastreabilidade: A base original não é alterada, permitindo consultar os dados brutos quando necessário e auditando todas as transformações realizadas.
- É sistemática e reproduzível: A função converter_numero() é aplicada a todas as colunas numéricas com across(), garantindo tratamento consistente e evitando repetição de código.
- É documentada e transparente: Cada etapa é explicada e justificada, permitindo que outro engenheiro compreenda o processo e valide as decisões tomadas.
- Mantém a integridade dos dados: Os valores suspeitos são sinalizados, mas não corrigidos automaticamente, pois a confirmação exige consulta às fichas originais de ensaio. Isso evita decisões baseadas em suposições.
- Utiliza ferramentas adequadas ao problema: O Tidyverse facilita a leitura e manutenção do código, com verbos que descrevem claramente cada ação, tornando o fluxo de transformação compreensível mesmo para quem não é especialista em programação.
- Alinha-se às boas práticas de Engenharia: Decisões conservadoras sobre valores ausentes e suspeitos refletem a responsabilidade profissional, onde a segurança estrutural não pode ser comprometida por suposições estatísticas não verificadas.