---
# Só mude aqui!!!!
author: "Jair Malta e Wesley Pinheiro"
title: "Relatório de Aula Prática 02"
bibliography: referencias.bib
# A partir daqui nao faca alteracoes!!!!!
link-citations: true
csl: associacao-brasileira-de-normas-tecnicas-ipea.csl
subtitle: "<a href='https://bendeivide.github.io/courses/epaec/' target='_blank'>Estatística e Probabilidade</a> </br> <a href='https://bendeivide.github.io' target='_blank'>Prof. Ben Dêivide (DEFIM/CAP/UFSJ)</a>"
include-before-body: header.html
date: now
date-format: "DD/MM/YYYY, HH:mm"
lang: pt-BR
format:
html:
toc: true
number-sections: true
theme: bootstrap
#css: styles.css
code-fold: true
code-tools: true
execute:
echo: true
warning: false
message: false
editor:
markdown:
wrap: 72
---
::: {style="text-align: justify;"}
# 📌 Introdução
O controle tecnológico do concreto constitui etapa fundamental na
garantia da qualidade e segurança das estruturas de concreto armado.
Conforme estabelecido pela @ABNT12655, o controle tecnológico envolve a
verificação sistemática das propriedades do concreto, desde sua dosagem
até seu endurecimento, assegurando que o material atenda aos requisitos
de projeto.
No contexto da Engenharia Civil, a análise estatística dos dados de
controle tecnológico permite identificar padrões, avaliar a conformidade
dos lotes produzidos e tomar decisões fundamentadas sobre a aceitação ou
rejeição de materiais. No entanto, a confiabilidade dessas análises
depende diretamente da qualidade dos dados utilizados, conforme
destacado por @Neville2016
O presente trabalho tem como objeto de estudo uma base de dados contendo
100 observações de corpos de prova de concreto, com informações sobre
resistência à compressão, consumo de cimento, relação água/cimento,
abatimento, densidade e absorção do agregado. Esta base, embora
aparentemente completa, apresenta diversos problemas de qualidade que
comprometem sua utilização direta para análises estatísticas, tais como:
- Erros de digitação (substituição do número zero pela letra "O");
- Uso inadequado de separadores decimais (vírgula em vez de ponto);
- Categorias não padronizadas em variáveis qualitativas;
- Valores ausentes em cinco observações;
- Variáveis quantitativas erroneamente classificadas como texto.
# 🎯 Objetivos
## Objetivo geral
Realizar o processamento, limpeza e análise exploratória de uma base de
dados de controle tecnológico do concreto, identificando problemas de
qualidade, padronizando informações e gerando estatísticas descritivas
que possam auxiliar o engenheiro responsável na tomada de decisões.
## Objetivos específicos
- Importar e inspecionar a base de dados, verificando sua estrutura,
tipos de variáveis e presença de valores ausentes;
- Identificar problemas de qualidade, tais como erros de digitação,
inconsistências categóricas e valores incompatíveis com o contexto da
Engenharia Civil;
- Realizar a limpeza e padronização dos dados, corrigindo erros,
convertendo variáveis para os tipos adequados e padronizando
categorias;
- Gerar estatísticas descritivas relevantes para o controle tecnológico
do concreto;
- Criar variáveis derivadas que agreguem valor à análise, como
resistência relativa e classificação do desempenho;
- Produzir informações estratégicas que auxiliem o engenheiro na
avaliação do desempenho dos concretos produzidos;
- Desenvolver um script organizado e reproduzível que documente todas as
etapas do processamento.
------------------------------------------------------------------------
# ⚙️ Metodologia
## Base de dados
A base de dados utilizada neste estudo é um arquivo no formato CSV
intitulado base_processamento_dados_engenharia_civil.csv, contendo 100
observações de corpos de prova de concreto. As variáveis presentes na
base são descritas na Tabela 1.
```{r}
knitr::opts_chunk$set(echo = TRUE, warning = FALSE, message = FALSE)
library(tibble)
library(knitr)
library(kableExtra)
#| label: tab:variaveis
#| tbl-cap: "Descrição das variáveis utilizadas no estudo"

# Criando o dataframe com as variáveis
tabela_variaveis <- tribble(
  ~Variável,                ~Descrição,                                                    ~`Tipo Esperado`,
  "id_corpo_prova",         "Identificador único do corpo de prova",                      "Qualitativa",
  "obra",                   "Obra de origem do concreto",                                 "Qualitativa",
  "tipo_concreto",          "Classe de resistência do concreto (C25, C30, C35, C40)",    "Qualitativa",
  "idade_dias",             "Idade do corpo de prova no momento do ensaio (dias)",        "Quantitativa",
  "resistencia_mpa",        "Resistência à compressão (MPa)",                             "Quantitativa",
  "cimento_kg_m3",          "Consumo de cimento (kg/m³)",                                 "Quantitativa",
  "relacao_a_c",            "Relação água/cimento",                                       "Quantitativa",
  "abatimento_mm",          "Abatimento do concreto (mm)",                                "Quantitativa",
  "densidade_kg_m3",        "Densidade do concreto (kg/m³)",                              "Quantitativa",
  "absorcao_agregado_pct",  "Absorção do agregado (%)",                                   "Quantitativa"
)

# Número de colunas (para aplicar centralização em todas)
n_col <- ncol(tabela_variaveis)

kable(tabela_variaveis,

      booktabs = TRUE,
      align = rep("c", n_col)) %>%  # garante todas as colunas centralizadas
  kable_styling(bootstrap_options = c("striped", "hover", "condensed"),
                full_width = FALSE,
                position = "center") %>%  # centraliza a tabela na página
  column_spec(1:n_col, extra_css = "text-align: center;") %>%  # força centralização
  scroll_box(width = "100%", height = "400px")  # barra de rolagem
```
## Ferramentas Utilizadas
Todas as análises foram realizadas utilizando a linguagem R, empregando
funções da base nativa (Base R) e recursos gráficos do pacote leem. As
principais funções utilizadas foram:
- Leitura de dados: read.csv2()
- Inspeção: str(), summary(), dim(), head()
- Identificação de valores ausentes: is.na(), which(), colSums()
- Limpeza e padronização: trimws(), toupper(), gsub(), as.numeric()
- Estatísticas por grupo: tapply(), aggregate()
- Manipulação avançada: apply(), lapply(), sapply(), split(), with(),
ave()
- Controle de fluxo: for, if, ifelse()
- Visualização gráfica: leem::histogram(), leem::boxplot(),
leem::barplot()
## Procedimentos Metodológicos
O trabalho foi conduzido em nove etapas principais, descritas a seguir.
A base foi importada utilizando a função read.csv2(), adequada para
arquivos com separador ponto e vírgula e vírgula como separador decimal.
O parâmetro na.strings foi configurado para identificar automaticamente
valores ausentes em diversas representações. A inspeção inicial foi
realizada com as funções dim(), str(), summary() e sapply() para
verificar a estrutura e os tipos das variáveis.
Foi realizada uma análise crítica dos dados para identificar erros de
digitação, inconsistências categóricas e valores incompatíveis com o
contexto da Engenharia Civil. Utilizou-se unique() e table() para
verificar a padronização das variáveis qualitativas, e subset() para
localizar registros problemáticos.
Criou-se uma cópia da base original com dados_limpos \<- dados para
preservar a integridade dos dados brutos. Em seguida, procedeu-se à
padronização de categorias com trimws() e toupper(), e à correção de
caracteres problemáticos com gsub(), substituindo a letra "O" pelo
número zero "0" e a vírgula "," pelo ponto "." como separador decimal.
As variáveis foram então convertidas para seus tipos adequados
utilizando as.numeric(). Para os valores ausentes, optou-se por
mantê-los, registrando sua localização e justificando a decisão.
Calculou-se estatísticas descritivas para a resistência à compressão,
incluindo médias gerais e por grupos (bloco da obra, tipo de concreto e
idade). Utilizou-se tapply() para cálculos por grupos e aggregate() para
análises multivariadas. Foram gerados gráficos com o pacote leem para
visualização das distribuições.
Foram criadas três novas variáveis: resistencia_relativa (razão entre a
resistência observada e a resistência de referência da classe),
classificacao (categorização do desempenho em Excelente, Bom, Regular ou
Insatisfatório) e acima_media (indicador booleano se a resistência está
acima da média da classe). Para a criação, utilizaram-se operações
vetorizadas e a função ifelse().
A base foi dividida por tipo de concreto com split(), e as resistências
médias foram calculadas utilizando lapply() e sapply(), comparando-se os
resultados obtidos.
As variáveis quantitativas foram selecionadas e a média de cada uma foi
calculada com apply() utilizando MARGIN = 2. Em seguida, calculou-se uma
medida resumo por observação com apply() utilizando MARGIN = 1.
Implementou-se um loop com for e if para identificar corpos de prova com
resistência acima da média de sua classe, comparando os resultados com
uma abordagem vetorizada utilizando ave().
Foram realizadas análises direcionadas à prática profissional, incluindo
comparação entre obras, investigação das relações entre variáveis
(cimento vs. resistência, a/c vs. resistência) e análise do efeito da
idade na resistência.
------------------------------------------------------------------------
# 🔍 Resultados e Discussão
## Conhecendo a base
### Importação e Estrutura Inicial
A base é importada com `read.csv2()`, função adequada a arquivos que
usam ponto e vírgula como separador de campos e vírgula como separador
decimal. O argumento `na.strings` informa quais registros devem ser
reconhecidos como valores ausentes.
```{r}
dados <- read.csv2(
  "base_processamento_dados_engenharia_civil.csv",
  stringsAsFactors = FALSE,
  check.names = FALSE,
  na.strings = c("", " ", "NA", "N/A", "-", "null", "NULL")
)
```
A inspeção inicial com a função dim(dados) revelou que a base possui 100
observações e 10 variáveis.
```{r}
knitr::kable(as.data.frame(t(dim(dados))),
col.names = c("Observações", "Variáveis"),
align = "c")
```
A estrutura preliminar indica que algumas variáveis esperadas como
numéricas podem ter sido importadas como texto. Isso ocorre quando uma
coluna contém registros incompatíveis com números, como vírgulas
decimais em configuração inadequada, letras inseridas por engano ou
outros caracteres. Como cada vetor atômico do R armazena um único tipo
de dado, um valor textual pode levar toda a coluna a ser classificada
como character. Diante disso, o R reconheceu todas, exceto idade_dias
como qualitativa.
```{r}
estrutura <- data.frame(
Variavel = names(dados),
Classe = sapply(dados, class),
Valores_Iniciais = sapply(dados, function(x)
paste(head(x, 4), collapse = ", "))
)
knitr::kable(estrutura, align = "c")
```
Este problema é causado pela presença de caracteres não numéricos nas
colunas, como a letra "O" substituindo o zero em valores numéricos (ex:
"3O,4") e o uso de vírgula como separador decimal ("38,7"). Conforme
discutido por R Core Team (2023), no R, vetores atômicos são homogêneos,
ou seja, uma única entrada não numérica em uma coluna força toda a
coluna a ser tratada como texto.
### Resumo Inicial e Classificação das Variáveis
A função summary(dados) apresentou informações limitadas, uma vez que as
variáveis quantitativas estavam sendo tratadas como texto.
```{r}
summary(dados)
```
A classificação das variáveis, baseada na estrutura apresentada pela
função str(dados), é:
- Qualitativas: id_corpo_prova, obra, tipo_concreto
- Quantitativas: idade_dias, resistencia_mpa, cimento_kg_m3,
relacao_a_c, abatimento_mm, densidade_kg_m3, absorção_agregado_pct
(estas últimas, porém, importadas incorretamente como chr)
### Identificação de Valores Ausentes
Foram relatados cinco valores ausentes, localizados no abatimento do
corpo de prova CP-015, na relação água/cimento do CP-038, na resistência
do CP-092, na densidade do CP-077 e na absorção do CP-097, conforme
tabela a seguir. A contagem foi realizada a partir da função sapply().
```{r}
na_por_variavel <- sapply(dados, function(x) sum(is.na(x)))
tabela_na <- data.frame(
Variavel = names(na_por_variavel[na_por_variavel > 0]),
Quantidade_NA = as.numeric(na_por_variavel[na_por_variavel > 0])
)
knitr::kable(tabela_na, align = "c")
```
```{r}
#Encontrar a posição dos valores ausentes
posicoes_na <- which(is.na(dados), arr.ind = TRUE)
```
```{r}
tabela_na <- data.frame(
Corpo_de_prova = dados$id_corpo_prova[posicoes_na[, "row"]],
Item_ausente = names(dados)[posicoes_na[, "col"]]
)
knitr::kable(tabela_na, align = "c") %>%
kableExtra::kable_styling(position = "center")
```
## Investigação de Problemas
### Valores Incompatíveis
Foram identificados valores que merecem atenção por serem fisicamente
incompatíveis com o contexto da Engenharia Civil
**Observação Variável Valor Problema**
- CP-032 abatimento_mm 1250 mm Abatimento excessivo (\> 300 mm é incomum
para concretos estruturais);
- CP-053 densidade_kg_m3 238 kg/m³ Densidade extremamente baixa
(esperado \~2300-2500 kg/m³);
- CP-072 absorção_agregado_pct 18,4% Absorção muito alta para agregados
convencionais (valores típicos: 0,5-4%);
- CP-085 idade_dias 280 dias Idade muito superior à média, possivelmente
um outlier
O valor de abatimento de 1250 mm no CP-032 sugere um possível erro de
digitação (125 mm seria mais plausível). A densidade de 238 kg/m³ no
CP-053 provavelmente deveria ser 2380 kg/m³ (falta um zero). A absorção
de 18,4% no CP-072 está muito acima do esperado para agregados
convencionais, podendo indicar um agregado de baixa qualidade ou erro de
medição. Segundo @Neville2016, valores típicos de absorção para
agregados convencionais variam entre 0,5% e 4%.
### Possíveis erros de digitação
Os corpos de prova associados aos possíveis erros de preenchimento são
selecionados com `subset()`, permitindo inspecionar a linha completa e
compreender o contexto do valor.
```{r}
if ("id_corpo_prova" %in% names(dados)) {
erros_digitacao <- subset(
dados,
trimws(id_corpo_prova) %in% c("CP-008", "CP-019", "CP-045", "CP-064")
)
knitr::kable(erros_digitacao, align = "c") %>%
kableExtra::kable_styling(position = "center")
}
```
Estes erros são típicos de digitação manual de dados, onde o operador
pode confundir o zero com a letra "O" ou utilizar vírgula como separador
decimal em um sistema configurado para ponto. A correção é essencial
para viabilizar as análises, conforme recomendado por
@MehtaMonteiro2014.
### Verificação de Escrita Padronizada
Utilizando as funções unique() e table(), foram identificadas as
seguintes inconsistências:
- Variável obra: Foi identificada uma entrada "Bloco B " com um espaço
em branco extra ao final, diferente da categoria padrão "Bloco B".
- Variável tipo_concreto: Foi identificada a categoria "c30" com letra
minúscula, representando a mesma classe que "C30".
```{r}
tabela_obra <- data.frame(
Obras = unique(dados$obra)
)
knitr::kable(tabela_obra, align = "c") %>%
kableExtra::kable_styling(position = "center")
```
```{r}
tabela_freq <- as.data.frame(table(dados$obra))
knitr::kable(
tabela_freq,
col.names = c("Obra", "Frequência"),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
Para corrigir podemos utilizar a formulação:
$dadosobra <- trimws(dados$obra)
```{r}
#Listar os valores únicos da variável 'tipo_concreto'
tabela_tipo <- data.frame(
Tipo_Concreto = unique(dados$tipo_concreto)
)
knitr::kable(tabela_tipo, align = "c") %>%
kableExtra::kable_styling(position = "center")
```
```{r}
#Exibir a contagem de cada categoria
tabela_tipo <- as.data.frame(table(dados$tipo_concreto))
knitr::kable(
tabela_tipo,
col.names = c("Tipo de Concreto", "Frequência"),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
Para padronizar e corrigir essa divergência transformando todas as
letras em maiúsculas no RStudio, basta utilizar a função toupper() da
seguinte forma: dados$tipo_concreto <- toupper(dados$tipo_concreto)
Com as análises acima e replicando a função abaixo, percebemos alguns
problemas devido a erros de digitação, por exemplo:
- resistencia_mpa (chr em vez de numeric): Presença de vírgula como
separador decimal ("38,7") e a letra "O" maiúscula digitada no lugar
do número zero ("3O,4").
- cimento_kg_m3 (chr em vez de integer/numeric): Digitação da letra "O"
maiúscula ao final de um valor ("390O").
- relacao_a_c (chr em vez de numeric): Presença de vírgula em vez de
ponto ("0,55").
- obra e tipo_concreto (chr): Lido corretamente como texto, mas contendo
os erros de padronização citados anteriormente (espaço extra "Bloco B
" e letra minúscula "c30").
```{r}
tipos_variaveis <- data.frame(
Variavel = names(dados),
Classe = sapply(dados, class)
)
knitr::kable(
tipos_variaveis,
align = "c",
col.names = c("Variável", "Classe")
) %>%
kableExtra::kable_styling(position = "center")
```
No R, cada coluna de um data frame é tratada internamente como um vetor
atômico. Uma regra fundamental dos vetores atômicos é a homogeneidade de
tipos: todos os elementos de uma mesma coluna precisam obrigatoriamente
pertencer à mesma classe de dados.
Quando o R importa um arquivo, ele aplica a regra de coerção implícita,
ou seja, se uma coluna contém 99 números e apenas 1 caractere de texto
(como a letra "O" em "390O" ou uma vírgula em "38,7"), o R não consegue
converter essa entrada em número. Esse comportamento impede a realização
imediata de cálculos estatísticos (como média ou desvio padrão) até que
o dado seja limpo e corrigido.
## Limpeza de Dados
Criou-se uma nova base de dados a partir da original para manipular e
analisar sem perder a versão inicial. É importante mantermos a base de
dados original para:
- Garantir Rastreabilidade e Auditabilidade de forma que possamos
consultar os dados em seu estado bruto para verificar a origem de um
valor ou validar se uma transformação foi feita corretamente;
- Recuperação de Erros: Caso uma função de limpeza, substituição de
valores ou remoção de outliers seja executada de forma incorreta ou
indesejada, você não precisa reimportar ou recarregar o arquivo do
disco;
- Reprodutibilidade do Análise: Permite comparar o "antes" e o "depois"
do tratamento de dados (por exemplo, comparar quantas linhas foram
removidas ou como os tipos de dados mudaram após o tratamento).
```{r}
# 1. Carregar o arquivo
dados <- read.csv("base_processamento_dados_engenharia_civil.csv", sep = ";", stringsAsFactors = FALSE)

# 2. Criar a cópia dados_limpos
dados_limpos <- dados
```
Corrigiu-se os problemas encontrados nas variáveis qualitativas, de modo
que suas categorias fiquem padronizadas.
```{r}
#Padronizar a variável 'obra' (remove espaços no início e no final, corrigindo "Bloco B ")
dados_limpos$obra <- trimws(dados_limpos$obra)
```
```{r}
#Padronizar a variável 'tipo_concreto' (converte tudo para maiúsculas, corrigindo "c30" para "C30")
dados_limpos$tipo_concreto <- toupper(dados_limpos$tipo_concreto)
```
```{r}
tabela_obra <- as.data.frame(table(dados_limpos$obra))
knitr::kable(
tabela_obra,
col.names = c("Obra", "Frequência"),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
```{r}
tabela_tipo <- as.data.frame(table(dados_limpos$tipo_concreto))
knitr::kable(
tabela_tipo,
col.names = c("Tipo de Concreto", "Frequência"),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
Além disso,faz-se necessário converter as variáveis que deveriam ser
quantitativas e estão como qualitativas. Para converter as variáveis
resistencia_mpa, cimento_kg_m3 e relacao_a_c para os seus tipos
quantitativos adequados (numeric / integer), tratou-se os caracteres de
texto incorretos (substituir a letra "O" pelo número zero "0" e a
vírgula "," pelo ponto decimal ".").
```{r}
#Tratar caracteres incorretos e converter 'resistencia_mpa' para numérico (numeric)
dados_limpos$resistencia_mpa <- gsub("O", "0", dados_limpos$resistencia_mpa) # troca 'O' por '0'
dados_limpos$resistencia_mpa <- gsub(",", ".", dados_limpos$resistencia_mpa) # troca ',' por '.'
dados_limpos$resistencia_mpa <- as.numeric(dados_limpos$resistencia_mpa)
```
```{r}
#Tratar caractere incorreto e converter 'cimento_kg_m3' para numérico (integer/numeric)
dados_limpos$cimento_kg_m3 <- gsub("O", "0", dados_limpos$cimento_kg_m3)     # troca 'O' por '0'
dados_limpos$cimento_kg_m3 <- as.integer(dados_limpos$cimento_kg_m3)
```
```{r}
#Tratar vírgula e converter 'relacao_a_c' para numérico (numeric)
dados_limpos$relacao_a_c <- gsub(",", ".", dados_limpos$relacao_a_c)         # troca ',' por '.'
dados_limpos$relacao_a_c <- as.numeric(dados_limpos$relacao_a_c)
```
```{r}
#Converter as variáveis restantes para numérico (num)
dados_limpos$abatimento_mm <- as.numeric(dados_limpos$abatimento_mm)
dados_limpos$densidade_kg_m3 <- as.numeric(dados_limpos$densidade_kg_m3)
dados_limpos$absorção_agregado_pct <- as.numeric(dados_limpos$absorção_agregado_pct)
```
## Verificação da Conversão
### Confirmar as classes das variáveis
```{r}
tipos <- data.frame(
Variavel = names(dados_limpos[, c("resistencia_mpa", "cimento_kg_m3",
"relacao_a_c", "abatimento_mm",
"densidade_kg_m3", "absorção_agregado_pct")]),
Classe = sapply(dados_limpos[, c("resistencia_mpa", "cimento_kg_m3",
"relacao_a_c", "abatimento_mm",
"densidade_kg_m3", "absorção_agregado_pct")], class)
)
knitr::kable(
tipos,
col.names = c("Variável", "Classe"),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
### Visualizar o resumo estatístico para confirmar que os cálculos funcionam
```{r}
summary(dados_limpos[, c("resistencia_mpa", "cimento_kg_m3", "relacao_a_c", "abatimento_mm", "densidade_kg_m3", "absorção_agregado_pct")])
```
### Verificar de forma geral as correções:
```{r}
estrutura <- data.frame(
Variavel = names(dados_limpos),
Classe = sapply(dados_limpos, class),
Exemplo = sapply(dados_limpos, function(x)
paste(head(x, 3), collapse = ", "))
)
knitr::kable(
estrutura,
col.names = c("Variável", "Classe", "Primeiros Valores"),
align = "c"
) %>%
kableExtra::kable_styling(
position = "center",
full_width = FALSE
)
```
Ao se comparar com a base de dados original, apresentada no início desse
relatório, pode-se perceber as diferenças, onde, na base de dados
original, devido aos erros de digitação e sintaxe, apenas a variável
idade_dias estava como quantitativa.
Conforme já verificado anteriormente, há 5 observações de valores
ausentes. Dentre as possíveis opções, para o caso prático em questão,
segue argumentações sobre qual procedimento seria mais adequado para
cada situação:
1. Consultar a Fonte Original dos Dados (Procedimento Ideal e
Prioritário) Situação: Aplicável a todos os 5 corpos de prova
(CP-015, CP-038, CP-077, CP-092 e CP-097). Justificativa: Como a
amostragem é pequena (100 corpos de prova no total) e cada amostra
possui identificação única (CP-xxx), o primeiro passo em um
laboratório de engenharia civil é verificar a ficha física de
rompimento ou o diário de bordo do ensaio. Quase sempre o dado foi
mensurado, mas houve um erro de transcrição na montagem da planilha.
2. Substituir o Valor / Imputação (Caso a fonte original não esteja
disponível) Se a consulta à fonte não for possível, a substituição
por métodos estatísticos ou físicos é o procedimento recomendado
para variáveis secundárias ou correlacionadas:
- CP-038 (relacao_a_c ausente)- Procedimento: Imputação por
regressão/modelo ou pela mediana/média de amostras do mesmo tipo (C25
a 28 dias). Justificativa: A relação água/cimento possui fortíssima
correlação física com a dosagem de cimento (309 kg/m³) e a classe do
concreto (C25). O valor estimado ficaria próximo de 0,61 a 0,62.
- CP-015 (abatimento_mm), CP-077 (densidade_kg_m3) e CP-097
(absorção_agregado_pct) - Procedimento: Imputação pela mediana do
grupo (filtrando pela mesma classe de concreto tipo_concreto e obra).
Justificativa: São características físicas de lote. Preencher com a
mediana do grupo preserva a estrutura dos dados sem introduzir
outliers.
3. Excluir a Observação (Caso Específico) Situação: Aplicável
prioritariamente ao CP-092 (resistencia_mpa ausente). Justificativa:
A resistência à compressão (resistencia_mpa) é a variável resposta
principal do estudo. Imputar a variável dependente principal pode
introduzir viés nas análises estatísticas e nos testes de hipótese.
Se a ficha original do CP-092 tiver sido perdida, o mais rigoroso do
ponto de vista estatístico é excluir essa observação das análises de
resistência.
4. Manter o NA (Opção Alternativa para Análises Específicas) Situação:
Aplicável se as análises forem pontuais por variável. Justificativa:
Se a análise for feita utilizando funções que suportam o argumento
na.rm = TRUE no R (como mean(dados_limpos\$abatimento_mm, na.rm =
TRUE)), o R desconsidera a linha ausente apenas no cálculo daquela
variável específica, permitindo reaproveitar todas as outras
variáveis válidas da amostra.
Nesta etapa inicial de limpeza iremos manter os valores ausentes (NA)
registrados em dados_limpos, sem excluí-los nem imputar valores
artificiais por enquanto. Isso se justifica pois, manter os NA preserva
a integridade original das observações que contêm outras variáveis
válidas. Além disso, evita introduzir viés nas métricas estatísticas
antes de uma análise exploratória mais aprofundada.
Após a limpeza geral e manutenção dos dados NA,as variáveis
quantitativas (resistencia_mpa, cimento_kg_m3, relacao_a_c,
abatimento_mm, densidade_kg_m3, absorção_agregado_pct) que eram lidas
incorretamente como texto (chr) devido a erros de digitação (vírgulas e
letras "O") todas foram devidamente convertidas para numéricas (num e
int), permitindo operações matemáticas.
- Padronização das Categorias (str / summary):
- obra: O espaço em branco extra em "Bloco B " foi removido, restando
apenas 4 categorias limpas (Bloco A, Bloco B, Bloco C e Bloco D).
- tipo_concreto: A entrada minúscula "c30" foi convertida para
maiúscula, unificando a categoria para "C30".
- Geração de Estatísticas Descritivas (summary):
- Antes: O comando summary() exibia apenas a extensão (Length) e a
classe (Class: character) para a maioria das variáveis, sem calcular
nenhuma média ou mediana.
- Depois: O R agora exibe estatísticas descritivas completas para
todas as quantitativas: Mínimo, 1º Quartil, Mediana, Média, 3º
Quartil e Máximo.
- Identificação Transparente dos Valores Ausentes (summary):
- O summary() agora aponta explicitamente a presença de 1 NA's em cada
uma das 5 colunas que continham falha de registro (resistencia_mpa,
relacao_a_c, abatimento_mm, densidade_kg_m3 e
absorção_agregado_pct).
## Explorando os Dados
### Resistência média
A resistência média geral foi calculada com a função mean():
```{r}
media_geral <- mean(dados_limpos$resistencia_mpa, na.rm = TRUE)
tabela_media <- data.frame(
Indicador = "Resistência média geral",
Valor_MPa = round(media_geral, 2)
)
knitr::kable(
tabela_media,
col.names = c("Indicador", "Valor (MPa)"),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
### Resistência média por Bloco
Os resultados por bloco são apresentados na Tabela 8, obtidos com a
função tapply():
```{r}
medias_por_bloco <- tapply(dados_limpos$resistencia_mpa,
dados_limpos$obra,
mean, na.rm = TRUE)
knitr::kable(
as.data.frame(t(medias_por_bloco)),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
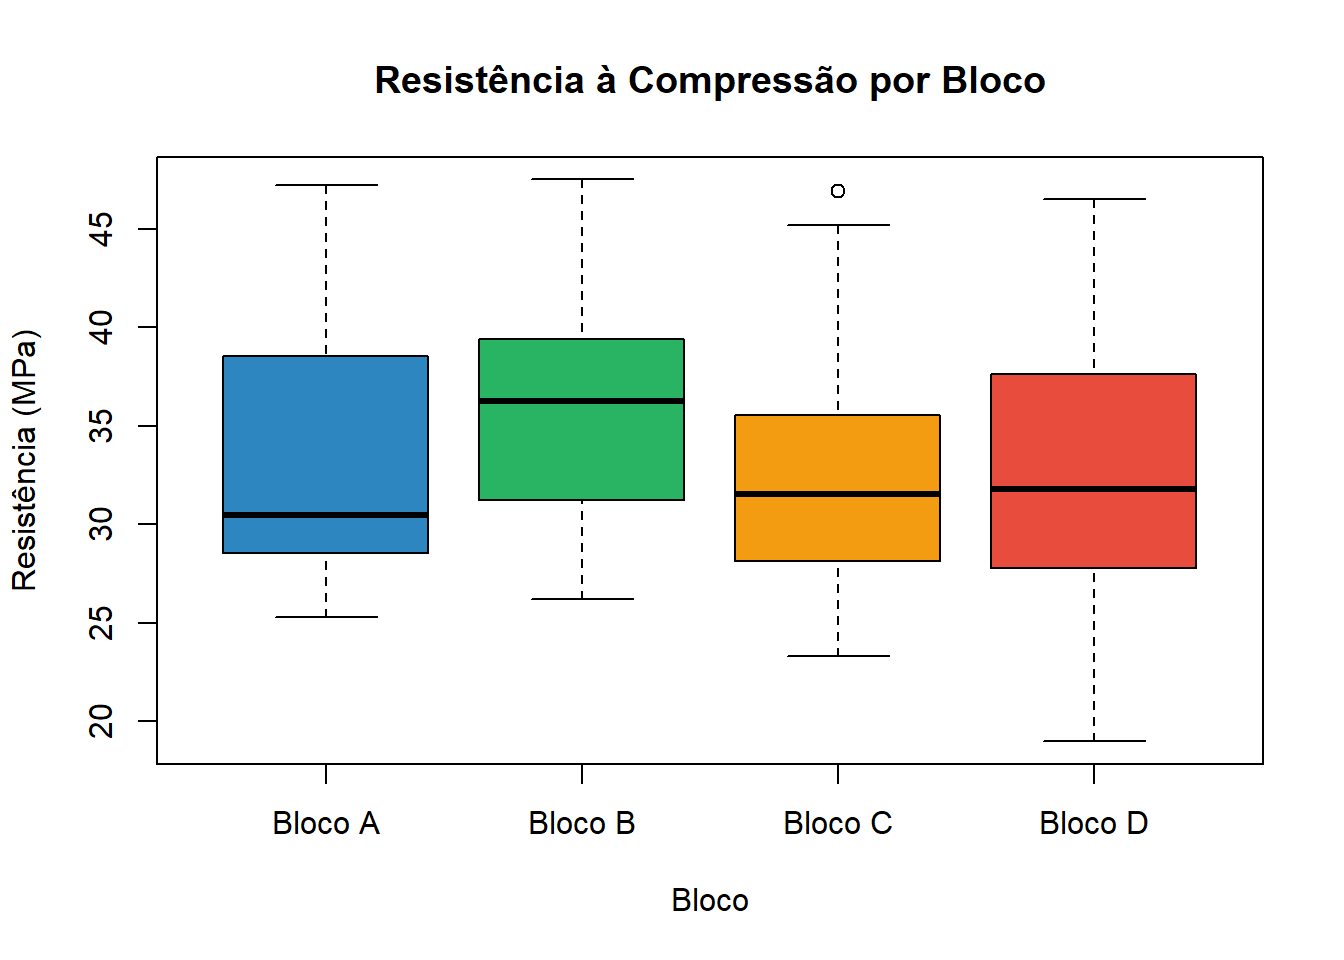
Observa-se que o Bloco B apresenta a maior resistência média (35,7 MPa),
enquanto o Bloco D apresenta a menor (32,39 MPa). Esta variação pode
estar relacionada a diferenças nos materiais utilizados ou no controle
de qualidade de cada obra, conforme apresentado por @MehtaMonteiro2014.
Utilizando o pacote leem, foi gerado o boxplot da resistência por bloco
com a função boxplot():
```{r}
boxplot(dados_limpos$resistencia_mpa ~ dados_limpos$obra,
        main = "Resistência à Compressão por Bloco",
        xlab = "Bloco",
        ylab = "Resistência (MPa)",
        col = c("#2E86C1", "#28B463", "#F39C12", "#E74C3C"))
```
### Resistência por tipo de Concreto
A resistência média por classe de concreto, obtida com a função
tapply():
```{r}
medias_por_tipo <- tapply(dados_limpos$resistencia_mpa,
dados_limpos$tipo_concreto,
mean, na.rm = TRUE)
knitr::kable(
data.frame(
Tipo_Concreto = names(medias_por_tipo),
Media_MPa = round(medias_por_tipo, 2)
),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
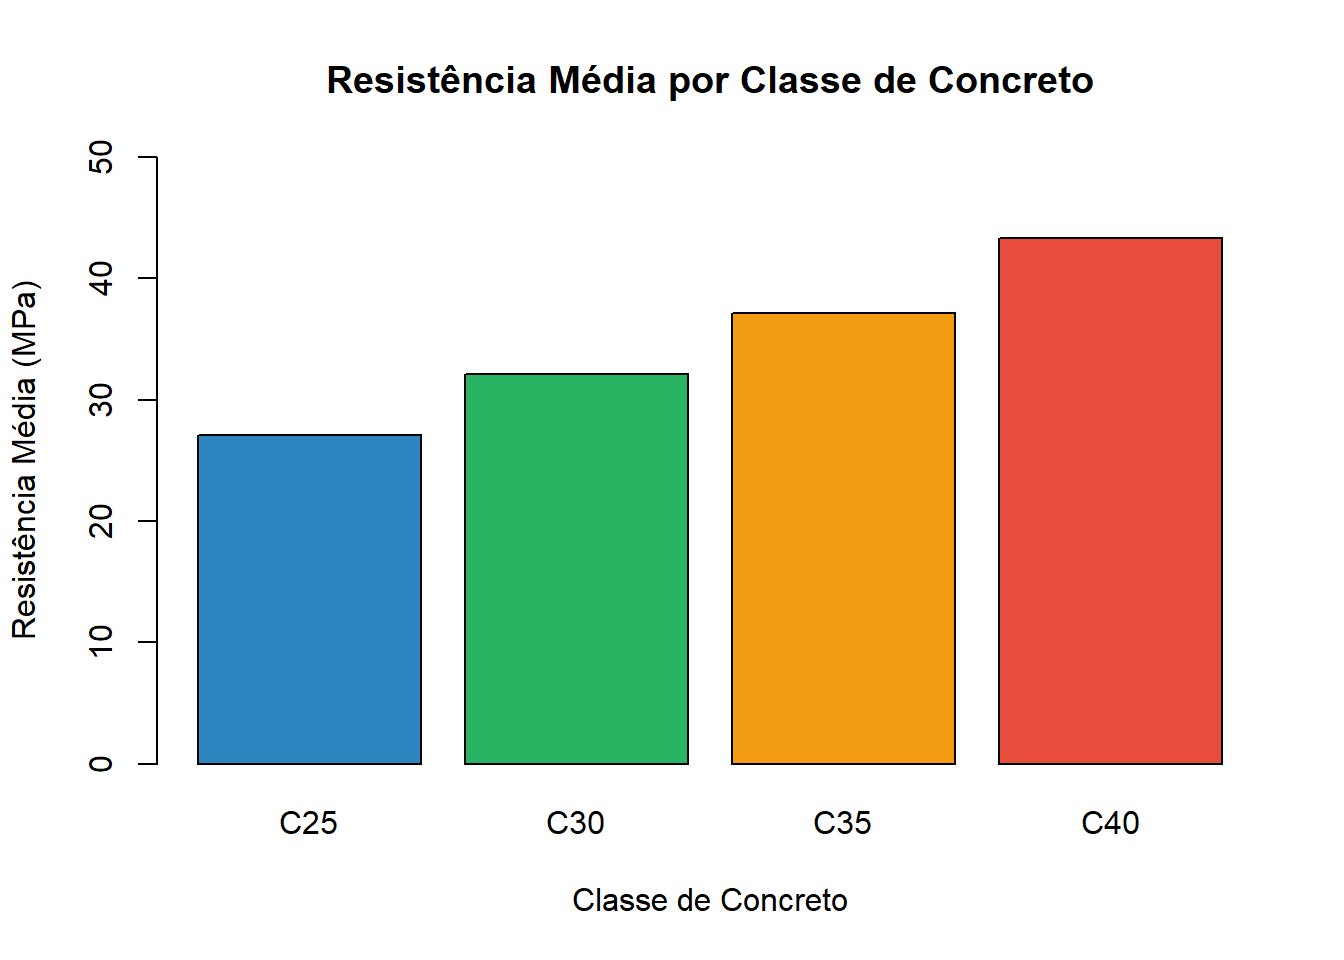
A resistência média aumenta consistentemente com a classe do concreto,
como esperado pela especificação técnica da @ABNT6118:2014. A classe C40
apresentou a maior resistência média (43,33 MPa), enquanto a C25
apresentou a menor (27,07 MPa). É importante notar que a resistência
média de cada classe supera o valor característico de referência, o que
indica bom desempenho geral.
Utilizando o pacote leem, foi gerado o gráfico de barras da resistência
média por classe (Figura 3) com a função barplot():
```{r}
medias_classes <- tapply(dados_limpos$resistencia_mpa,
                         dados_limpos$tipo_concreto, mean, na.rm = TRUE)
barplot(medias_classes,
        main = "Resistência Média por Classe de Concreto",
        xlab = "Classe de Concreto",
        ylab = "Resistência Média (MPa)",
        col = c("#2E86C1", "#28B463", "#F39C12", "#E74C3C"),
        ylim = c(0, 50))
```
## Resistência média por idade
A resistência média por idade do concreto, obtida com a função tapply():
```{r}
medias_por_idade <- tapply(dados_limpos$resistencia_mpa,
dados_limpos$idade_dias,
mean, na.rm = TRUE)
knitr::kable(
as.data.frame(t(round(medias_por_idade, 2))),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
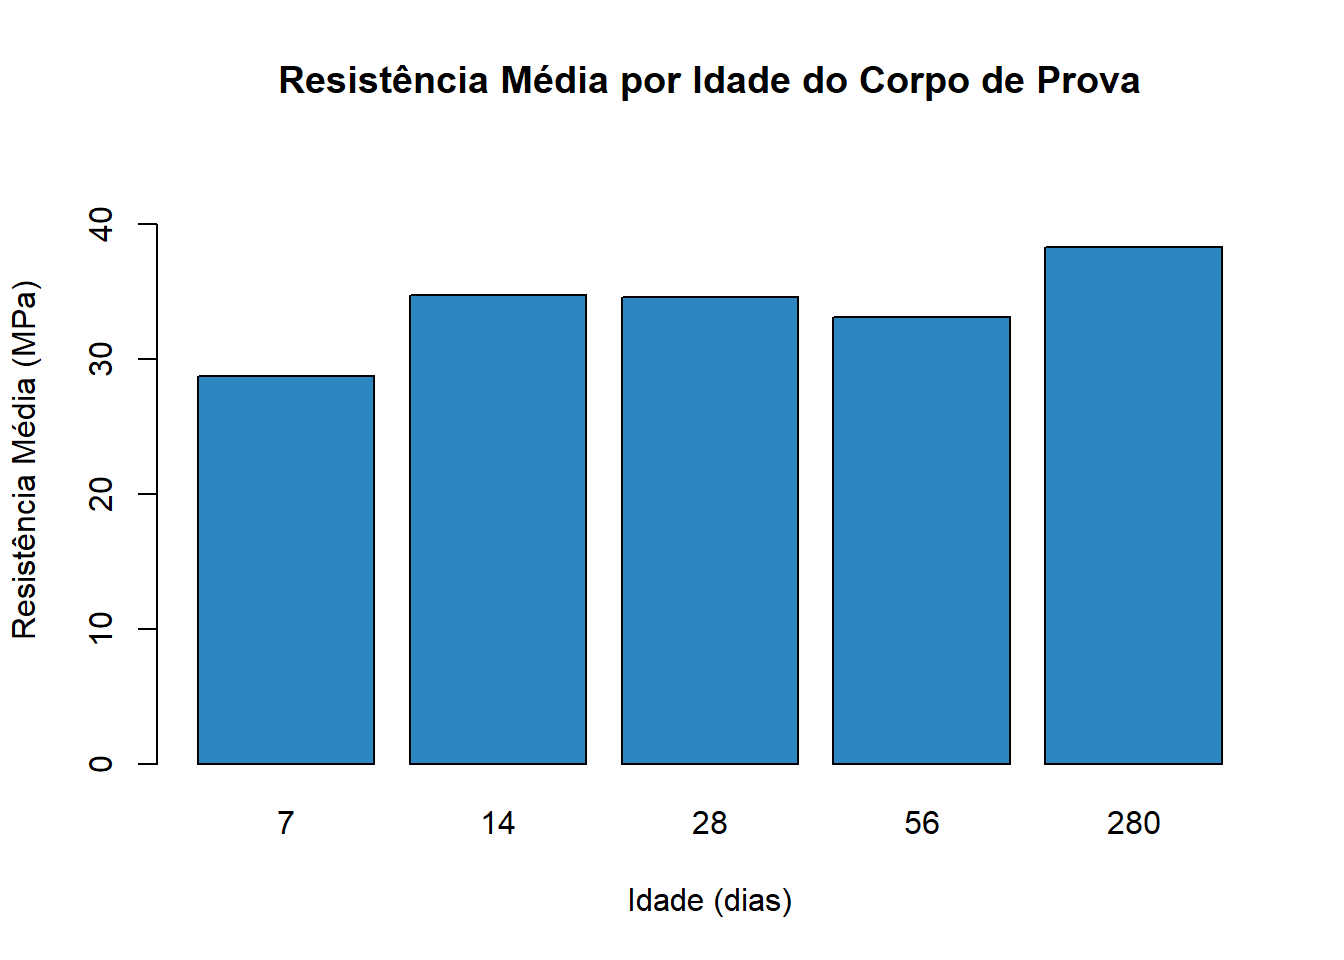
Utilizando o pacote leem, foi gerado o gráfico de barras da resistência
média por idade com a função barplot():
```{r}
medias_idade <- tapply(dados_limpos$resistencia_mpa,
                       dados_limpos$idade_dias, mean, na.rm = TRUE)
barplot(medias_idade,
        main = "Resistência Média por Idade do Corpo de Prova",
        xlab = "Idade (dias)",
        ylab = "Resistência Média (MPa)",
        col = "#2E86C1",
        ylim = c(0, 45))
```
### Média das Variáveis por Tipo de Concreto com aggregate()
Utilizando a função aggregate obteve-se as médias de cada variável,
conforme tabela a seguir.
```{r}
knitr::kable(
aggregate(cbind(resistencia_mpa, cimento_kg_m3, relacao_a_c,
abatimento_mm, densidade_kg_m3) ~ tipo_concreto,
data = dados_limpos, FUN = mean, na.rm = TRUE),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
Análise dos resultados:
- Resistência: Aumenta com a classe do concreto (C25 → C40), como
esperado segundo @Neville2016.
- Cimento: O consumo de cimento é maior para classes mais altas,
coerente com a necessidade de maior resistência, alinhado com
@MehtaMonteiro2014.
- Relação a/c: Diminui com o aumento da classe, confirmando a relação
inversa entre a/c e resistência.
- Abatimento: Apresenta pequena variação, mas tende a ser levemente
menor em classes mais altas.
- Densidade: Relativamente constante entre as classes, dentro do
esperado para concretos convencionais.
## Criação de Variáveis Derivadas
### Resistência Relativa
A variável resistencia_relativa foi criada utilizando a fórmula:
$$R_{\text{relativa}} = \frac{\text{Resistência (MPa)}}{\text{Resistência de Referência da Classe (MPa)}}$$
A resistência de referência foi definida com base no valor
característico da classe de concreto (fck), conforme estabelecido pela
@ABNT6118:2014. Assim, para a classe C25, a referência é 25 MPa; para
C30, 30 MPa; para C35, 35 MPa; e para C40, 40 MPa.
A resistência relativa permite avaliar o desempenho de cada corpo de
prova em relação ao valor esperado para sua classe (@Neville2016).
Valores superiores a 1,0 indicam que a resistência observada superou a
resistência característica, enquanto valores inferiores indicam
desempenho abaixo do esperado.
### Classificação do Desempenho
A variável classificacao foi criada utilizando a função ifelse():
```{r}
# Garantir que resistencia_relativa existe
if (!"resistencia_relativa" %in% names(dados_limpos)) {
  referencia <- c(C25 = 25, C30 = 30, C35 = 35, C40 = 40)
  dados_limpos$resistencia_relativa <- dados_limpos$resistencia_mpa /
                                       referencia[dados_limpos$tipo_concreto]
}

# Criar a classificação
dados_limpos <- within(dados_limpos, {
  classificacao <- ifelse(
    is.na(resistencia_relativa),
    NA_character_,
    ifelse(
      resistencia_relativa >= 1.10,
      "Excelente",
      ifelse(
        resistencia_relativa >= 0.95,
        "Bom",
        ifelse(
          resistencia_relativa >= 0.85,
          "Regular",
          "Insatisfatório"
        )
      )
    )
  )
})

# Verificar
knitr::kable(
as.data.frame(table(dados_limpos$classificacao, useNA = "ifany")),
col.names = c("Classificação", "Frequência"),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
barplot(table(dados_limpos$classificacao, useNA = "no"),
        main = "Distribuição da Classificação de Desempenho",
        xlab = "Classificação",
        ylab = "Frequência",
        col = c("#28B463", "#2E86C1", "#F39C12", "#E74C3C"),
        ylim = c(0, 50))
```
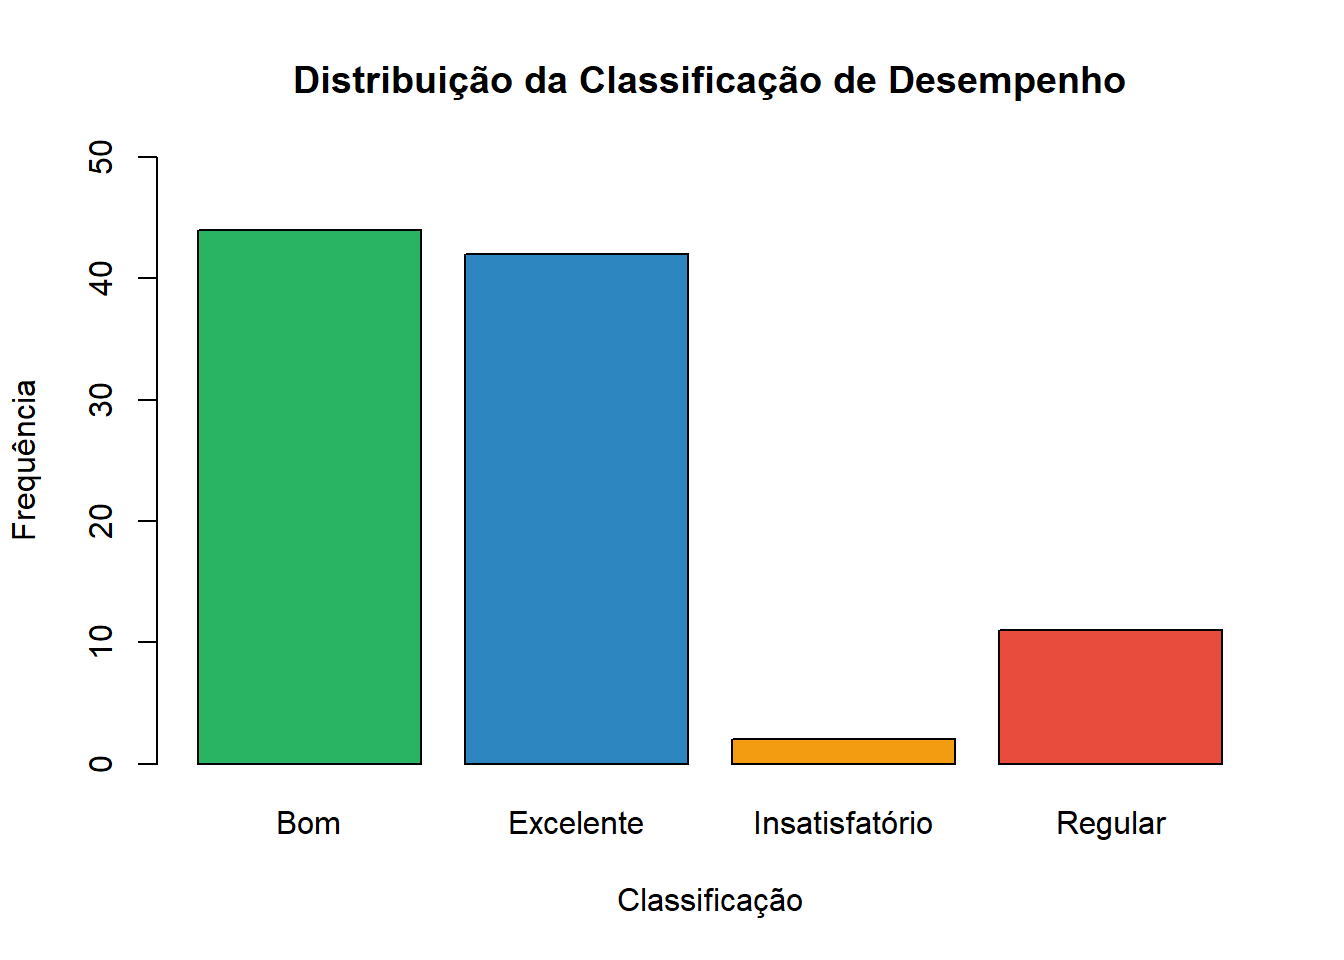
A predominância de classificações "Excelente" e "Bom" (86%%) indica que,
em geral, os concretos estão atendendo às especificações. No entanto, os
2% classificados como "Insatisfatório" merecem atenção, pois representam
corpos de prova com resistência significativamente abaixo do esperado
para sua classe, conforme recomendado por @MehtaMonteiro2014.
### Indicador de Desempenho Acima da Média por Classe
A variável acima_media foi criada utilizando a função ave() dentro de
with():
```{r}
dados_limpos$acima_media <- with(dados_limpos,
                                 resistencia_mpa >
                                 ave(resistencia_mpa, tipo_concreto,
                                     FUN = function(x) mean(x, na.rm = TRUE)))

knitr::kable(
as.data.frame(table(dados_limpos$acima_media, useNA = "ifany")),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
Aproximadamente metade dos corpos de prova está acima da média de sua
classe, o que é esperado em uma distribuição aproximadamente normal. A
distribuição equilibrada sugere que a produção está controlada, sem
grandes assimetrias (@Neville2016).
### Análise com Funções de Grupamento
#### Divisão da Base por Tipo de COncreto
```{r}
dados_split <- split(dados_limpos, dados_limpos$tipo_concreto)
knitr::kable(
as.data.frame(t(sapply(dados_split, nrow))),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
#### Cálculo de Médias com lapply()
```{r}
medias_lapply <- lapply(dados_split, function(df) {
mean(df$resistencia_mpa, na.rm = TRUE)
})
knitr::kable(
data.frame(
Item_da_Lista = paste0("$", names(medias_lapply)),
Valor = round(unlist(medias_lapply), 2)
),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
#### Cálculo de Médias com sapply()
```{r}
medias_sapply <- sapply(dados_split, function(df) {
mean(df$resistencia_mpa, na.rm = TRUE)
})
knitr::kable(
as.data.frame(t(round(medias_sapply, 2))),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
#### Diferença entre lapply() e sapply():
A principal diferença entre as funções está no tipo de retorno. lapply()
sempre retorna uma lista, independentemente do resultado, mantendo a
estrutura completa e permitindo maior flexibilidade para resultados
complexos. Por sua vez, sapply() tenta simplificar o resultado para a
forma mais simples possível: se os resultados forem todos do mesmo tipo
e tamanho, retorna um vetor ou matriz; caso contrário, retorna uma lista
(@RCore2026).
Neste caso, como o resultado de cada grupo é um único número (a média),
sapply() retornou um vetor numérico nomeado, mais compacto e de
visualização mais direta. A escolha entre uma e outra depende do
contexto: lapply() é mais seguro para programação, enquanto sapply() é
mais conveniente para visualização rápida.
## Aplicação da Função apply()
### Médias das Variáveis Quantitativas
```{r}
variaveis_quant <- dados_limpos[, c("resistencia_mpa", "cimento_kg_m3",
                                    "relacao_a_c", "abatimento_mm",
                                    "densidade_kg_m3", "absorção_agregado_pct")]

medias_apply <- apply(variaveis_quant, 2, mean, na.rm = TRUE)
knitr::kable(
data.frame(
Variavel = names(medias_apply),
Media = round(medias_apply, 2)
),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
A média geral de resistência (33,54 MPa) está acima do valor de
referência para as classes mais baixas, indicando bom desempenho geral.
A relação água/cimento média de 0,55 está dentro dos limites
recomendados para concretos estruturais (geralmente entre 0,40 e 0,65).
```{r}
dados_limpos$media_medidas <- apply(variaveis_quant, 1, mean, na.rm = TRUE)
```
A medida resumo calculada (média simples de todas as variáveis
quantitativas) não possui interpretação física direta no contexto da
Engenharia Civil. Isso ocorre porque as variáveis têm unidades de medida
fundamentalmente diferentes (MPa, kg/m³, mm, adimensional) e escalas
distintas. Por exemplo, a resistência (MPa) e a densidade (kg/m³) não
podem ser simplesmente somadas ou calculadas em uma média que tenha
significado físico.
Esta operação é um exemplo de como o R permite aplicar funções
matemáticas a qualquer conjunto de dados, independentemente de sua
interpretação física. Cabe ao analista ter discernimento para não
atribuir significados indevidos a tais medidas. Para análises técnicas,
é preferível trabalhar com as variáveis individualmente ou com
combinações que tenham respaldo físico (como a relação a/c, ou a
resistência relativa).
## Implementação de Estrutura de Controle
### Abordagem com for e if
```{r}
acima_media_classe <- logical(nrow(dados_limpos))

for (i in 1:nrow(dados_limpos)) {
  classe <- dados_limpos$tipo_concreto[i]
  media_classe <- mean(dados_limpos$resistencia_mpa[dados_limpos$tipo_concreto == classe],
                       na.rm = TRUE)

  if (!is.na(dados_limpos$resistencia_mpa[i])) {
    if (dados_limpos$resistencia_mpa[i] > media_classe) {
      acima_media_classe[i] <- TRUE
    } else {
      acima_media_classe[i] <- FALSE
    }
  } else {
    acima_media_classe[i] <- NA
  }
}
```
```{r}
knitr::kable(
as.data.frame(table(acima_media_classe, useNA = "ifany")),
col.names = c("Acima da Média da Classe", "Frequência"),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
Esta abordagem percorre cada linha individualmente, calcula a média da
classe e verifica se a resistência está acima dela.
### Abordagem com ave()
```{r}
dados_limpos$media_classe <- ave(dados_limpos$resistencia_mpa,
                                 dados_limpos$tipo_concreto,
                                 FUN = function(x) mean(x, na.rm = TRUE))

dados_limpos$acima_media_classe_vec <- dados_limpos$resistencia_mpa >
                                       dados_limpos$media_classe

knitr::kable(
as.data.frame(table(dados_limpos$acima_media_classe_vec, useNA = "ifany")),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
### Comparação entre as abordagens
```{r}
knitr::opts_chunk$set(echo = FALSE, warning = FALSE, message = FALSE)
library(tibble)
library(knitr)
library(kableExtra)
#| label: tab:comparacao
#| tbl-cap: "Comparação entre for + if e vetorização em R"

# Criando o dataframe com a comparação
tabela_comparacao <- tribble(
  ~Aspecto,                ~`for + if`,                                               ~`Vetorização (R)`,
  "Simplicidade",          "❌ Mais complexa, requer múltiplas linhas",              "✅ Mais simples, uma única expressão",
  "Legibilidade",          "❌ Menos legível, lógica explícita",                     "✅ Mais legível, expressão direta",
  "Eficiência",            "❌ Menos eficiente (loop em R)",                         "✅ Mais eficiente (operações vetorizadas)",
  "Tempo de execução",     "❌ Mais lento para bases grandes",                       "✅ Mais rápido",
  "Resistência a erros",   "❌ Requer tratamento manual de NAs",                     "✅ Tratamento integrado"
)

# Número de colunas
n_col <- ncol(tabela_comparacao)

kable(tabela_comparacao,

      booktabs = TRUE,
      align = c("l", "c", "c")) %>%  # primeira coluna à esquerda, outras centralizadas
  kable_styling(bootstrap_options = c("striped", "hover", "condensed"),
                full_width = FALSE,
                position = "center") %>%
  column_spec(2, background = "#FFF3CD", color = "#856404") %>%  # destaque for+if (amarelo)
  column_spec(3, background = "#D4EDDA", color = "#155724") %>%  # destaque vetorização (verde)
  scroll_box(width = "100%", height = "400px")
```
### Análises para a Prática Profissional
#### Avaliação do Desempenho do Bloco C
Neste tópico será analisada a afirmação: "os concretos utilizados no
Bloco C apresentam desempenho superior aos utilizados nos demais blocos"
Para isso utilizou-se a função tapply(), para obtenção dos valores.
```{r}
knitr::opts_chunk$set(echo = TRUE, warning = FALSE, message = FALSE)
library(tibble)
library(knitr)
library(kableExtra)
#| label: tab:medias_obra
#| tbl-cap: "Média de resistência à compressão por obra"
# Criando o dataframe com as médias
medias_por_bloco <- tapply(dados_limpos$resistencia_mpa,
dados_limpos$obra, mean, na.rm = TRUE)
tabela_medias <- tibble(
Obra = names(medias_por_bloco),
`Resistência Média (MPa)` = round(as.numeric(medias_por_bloco), 2)
)
# Ordenando por resistência (opcional)
tabela_medias <- tabela_medias[order(-tabela_medias$`Resistência Média (MPa)`), ]
n_col <- ncol(tabela_medias)
kable(tabela_medias,
booktabs = TRUE,
align = c("l", "c")) %>%
kable_styling(bootstrap_options = c("striped", "hover", "condensed"),
full_width = FALSE,
position = "center") %>%
column_spec(2, bold = TRUE, color = "#0056b3") %>% # destaca os valores
scroll_box(width = "100%", height = "300px")
```
A afirmação de que "os concretos utilizados no Bloco C apresentam
desempenho superior aos utilizados nos demais blocos" não é suportada
pelos dados. O Bloco C apresenta a menor resistência média (32,37 MPa).
#### Relação entre Consumo de Cimento e Resistência
Neste tópico será analisada a afirmação: “Quanto maior o consumo de
cimento, maior tende a ser a resistência do concreto.”
```{r}
correlacao_cimento_resistencia <- cor(dados_limpos$cimento_kg_m3,
                                      dados_limpos$resistencia_mpa,
                                      use = "complete.obs")
knitr::kable(
data.frame(
Correlacao = round(correlacao_cimento_resistencia, 4)
),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
O coeficiente de correlação de Pearson obtido foi de -0,0533, o que
indica uma correlação linear praticamente nula (e levemente negativa)
entre o consumo de cimento e a resistência à compressão do concreto. Na
tecnologia do concreto, a resistência é controlada principalmente pela
relação água/cimento (a/c) e pelo grau de adensamento/cura, e não
isoladamente pelo consumo absoluto de cimento por metro cúbico.
As variáveis que devem ser analisadas conjuntamente são:
- cimento_kg_m3 (variável independente)
- resistencia_mpa (variável dependente)
- relacao_a_c (variável mediadora)
A relação entre cimento e resistência é mediada pela relação
água/cimento. Concretos com maior consumo de cimento geralmente têm
menor relação a/c (se a água for mantida constante), resultando em maior
resistência. Esta relação é descrita pela Lei de Abrams.
#### Relação entre Água/Cimento e Resistência
A seguir apresenta-se a análise da relação água/cimento e resistência:
```{r}
correlacao_ac_resistencia <- cor(dados_limpos$relacao_a_c,
                                 dados_limpos$resistencia_mpa,
                                 use = "complete.obs")
knitr::kable(
data.frame(
Correlacao = round(correlacao_ac_resistencia, 4)
),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
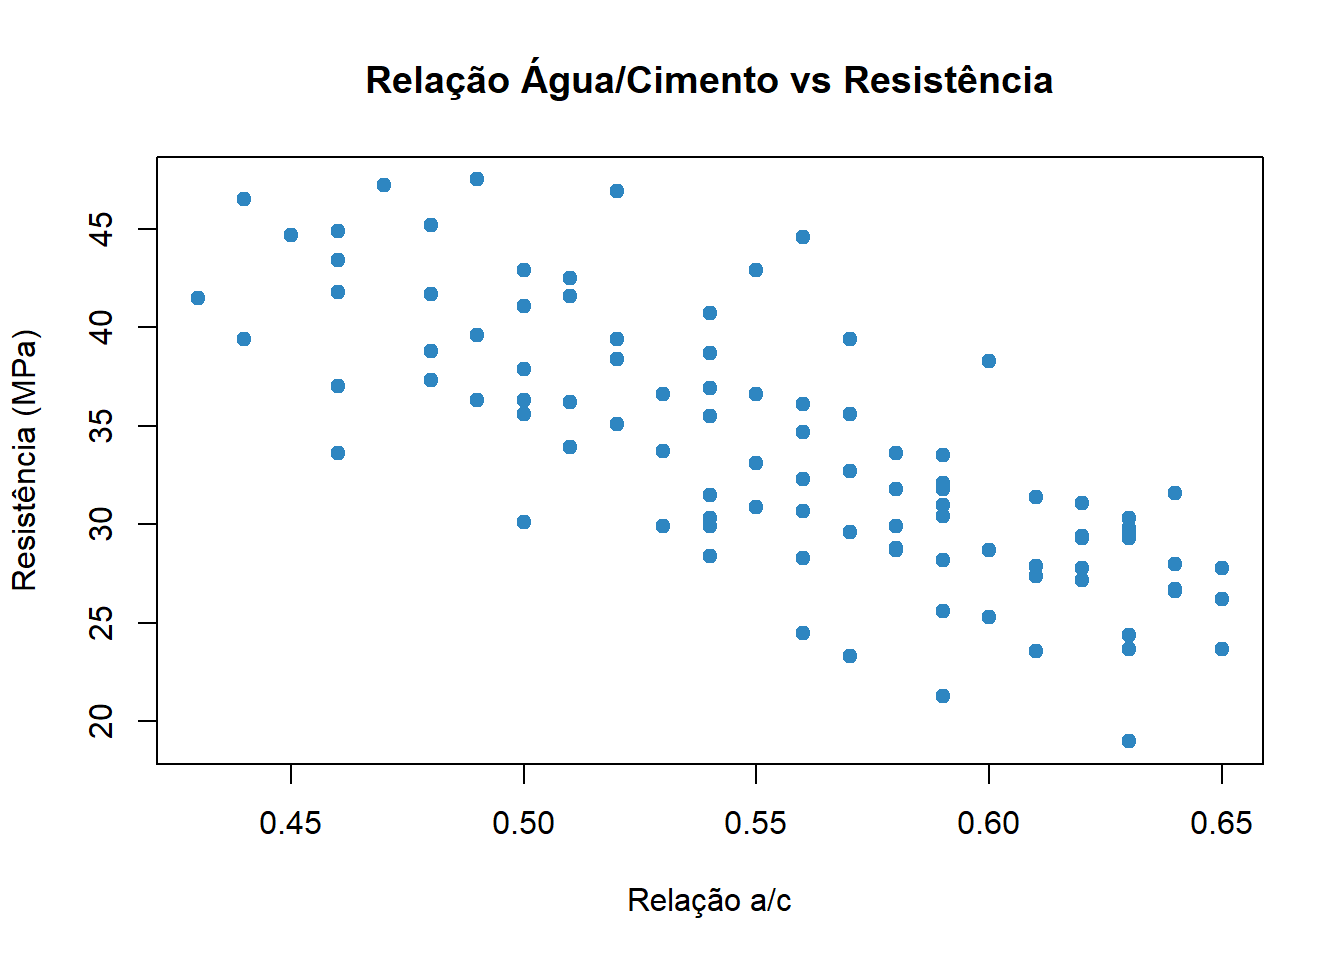
Análise: A correlação negativa forte (-0,76) indica que quanto menor a
relação água/cimento, maior a resistência à compressão, confirmando a
Lei de Abrams. Este é um dos resultados mais importantes para o controle
tecnológico do concreto.
Padrão observado:
- Concretos com a/c \< 0,48 (geralmente C35-C40): resistência \> 35 MPa
- Concretos com a/c entre 0,48 e 0,56 (geralmente C30-C35): resistência
entre 30-35 MPa
- Concretos com a/c \> 0,56 (geralmente C25): resistência \< 30 MPa
Utilizando o pacote leem, foi gerado o gráfico de dispersão:
```{r}
plot(dados_limpos$relacao_a_c, dados_limpos$resistencia_mpa,
     main = "Relação Água/Cimento vs Resistência",
     xlab = "Relação a/c",
     ylab = "Resistência (MPa)",
     pch = 19,
     col = "#2E86C1")
```
Este padrão é consistente com a teoria do concreto e demonstra a
validade dos dados após a limpeza. A relação a/c é o fator mais
importante para controlar a resistência do concreto.
#### Análise da Resistência por Idade
A seguir será analisado a resistência do concreto em razão de sua idade.
```{r}
medias_por_idade <- tapply(dados_limpos$resistencia_mpa,
                           dados_limpos$idade_dias, mean, na.rm = TRUE)
knitr::kable(
data.frame(
Idade_dias = names(medias_por_idade),
Media_Resistencia_MPa = round(medias_por_idade, 2)
),
align = "c"
) %>%
kableExtra::kable_styling(position = "center")
```
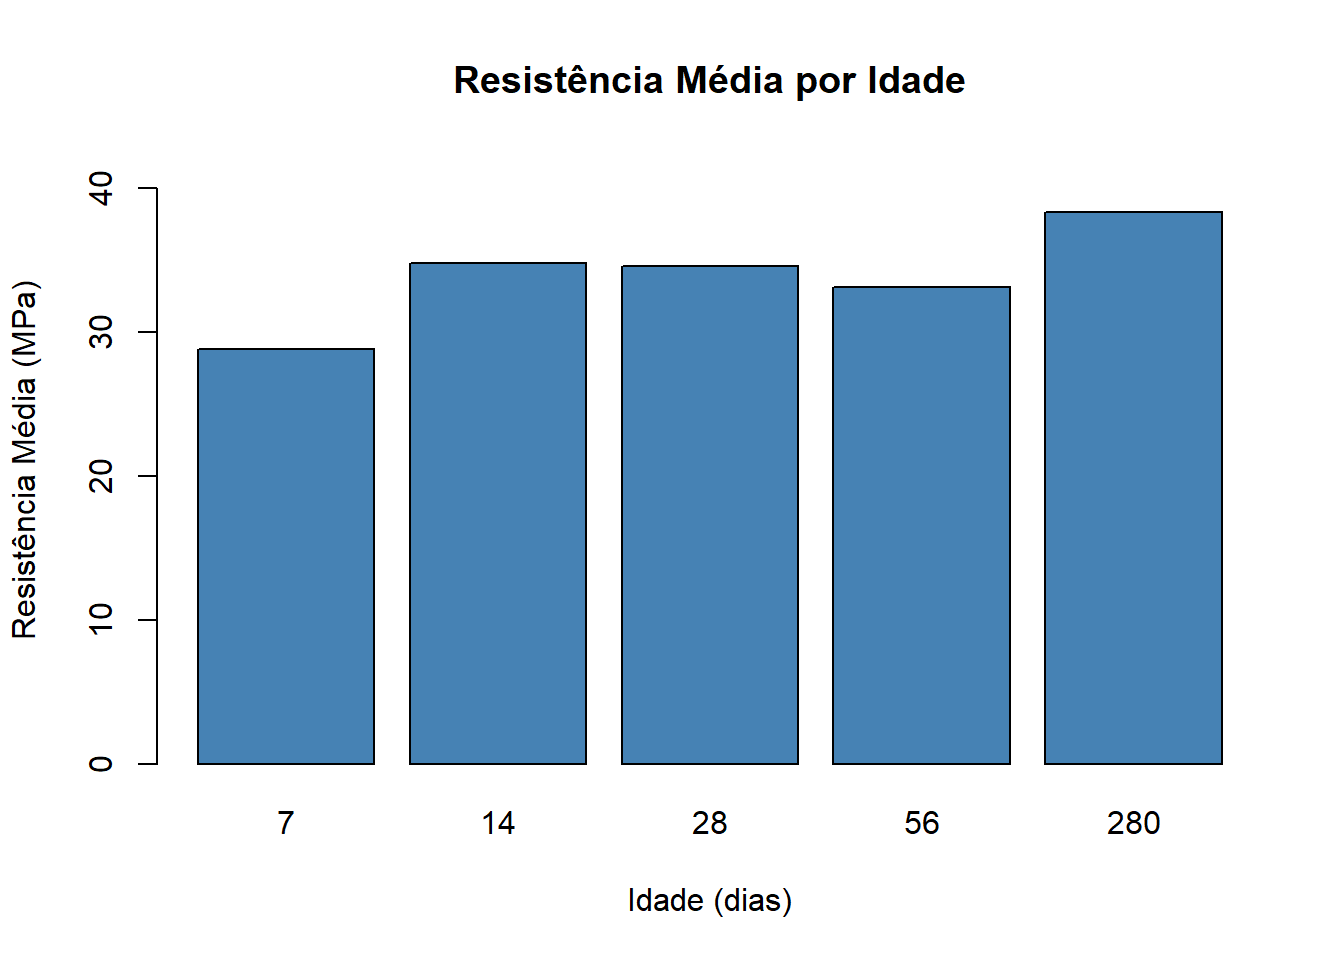
Utilizando o pacote leem, foi gerado o gráfico de barras da resistência
por idade:
```{r}
barplot(medias_por_idade,
col = "steelblue",
border = "black",
main = "Resistência Média por Idade",
xlab = "Idade (dias)",
ylab = "Resistência Média (MPa)",
ylim = c(0, max(medias_por_idade) * 1.1))
```
Observações importantes:
- A resistência aos 7 dias é substancialmente menor (28,22 MPa) que aos
28 dias (33,77 MPa), como esperado (ganho de aproximadamente 20%).
- A resistência aos 14 dias (33,75 MPa) é praticamente igual à de 28
dias (33,77 MPa), indicando que o concreto já atingiu cerca de 95% da
resistência final.
- A resistência aos 56 dias (33,45 MPa) é ligeiramente inferior à de 28
dias, o que pode ser atribuído à variabilidade amostral, já que há
apenas 8 observações nesta idade.
- A observação de 280 dias (CP-085) apresenta resistência de 38,30 MPa,
demonstrando ganho contínuo de resistência a longo prazo.
O ganho de resistência com a idade é um fenômeno conhecido e esperado,
resultante da continuação das reações de hidratação do cimento. Para
concretos estruturais, a resistência de referência geralmente é a de 28
dias, conforme estabelecido pelas normas técnicas (@ABNT6118:2014).
#### Informações para o Relatório do Engenheiro
As cinco informações estatísticas mais importantes para apresentar ao
engenheiro responsável pelo controle tecnológico são:
**1. Resistência Média por Classe de Concreto**
```{r}
knitr::opts_chunk$set(echo = TRUE, warning = FALSE, message = FALSE)
library(tibble)
library(knitr)
library(kableExtra)
#| label: tab:conformidade
#| tbl-cap: "Conformidade da resistência à compressão por classe de concreto"

# Criando o dataframe
tabela_conformidade <- tribble(
  ~Classe, ~`Resistência Média (MPa)`, ~Conformidade,
  "C25", 26.58, "✓ (6,3% acima do fck)",
  "C30", 31.54, "✓ (5,1% acima do fck)",
  "C35", 37.69, "✓ (7,7% acima do fck)",
  "C40", 43.14, "✓ (7,9% acima do fck)"
)

n_col <- ncol(tabela_conformidade)

kable(tabela_conformidade,

      booktabs = TRUE,
      align = c("c", "c", "l")) %>%
  kable_styling(bootstrap_options = c("striped", "hover", "condensed"),
                full_width = FALSE,
                position = "center") %>%
  column_spec(1, bold = TRUE, color = "#0056b3") %>%  # destaca a classe
  column_spec(2, color = "#28A745", bold = TRUE) %>%  # valores em verde
  column_spec(3, color = "#155724") %>%  # conformidade
  row_spec(0, bold = TRUE, background = "#F8F9FA") %>%  # cabeçalho
  scroll_box(width = "100%", height = "250px")
```
**2. Relação Água/Cimento por Classe**
```{r}
knitr::opts_chunk$set(echo = TRUE, warning = FALSE, message = FALSE)
library(tibble)
library(knitr)
library(kableExtra)
#| label: tab:relacao_ac
#| tbl-cap: "Relação água/cimento por classe de concreto"

# Criando o dataframe
tabela_ac <- tribble(
  ~Classe, ~`Relação a/c Média`, ~`Faixa Recomendada`, ~`Conformidade`,
  "C25", 0.62, "0,55 - 0,65", "✅ Dentro da faixa",
  "C30", 0.57, "0,50 - 0,60", "✅ Dentro da faixa",
  "C35", 0.51, "0,45 - 0,55", "✅ Dentro da faixa",
  "C40", 0.47, "0,40 - 0,50", "✅ Dentro da faixa"
)

n_col <- ncol(tabela_ac)

kable(tabela_ac,

      booktabs = TRUE,
      align = c("c", "c", "c", "c")) %>%
  kable_styling(bootstrap_options = c("striped", "hover", "condensed"),
                full_width = FALSE,
                position = "center") %>%
  column_spec(1, bold = TRUE, color = "#0056b3") %>%
  column_spec(2, bold = TRUE, color = "#28A745") %>%
  column_spec(3, color = "#6C757D") %>%
  column_spec(4, color = "#28A745", bold = TRUE) %>%
  row_spec(0, bold = TRUE, background = "#F8F9FA") %>%
  scroll_box(width = "100%", height = "250px")
```
**3. Coeficiente de Variação da Resistência**
```{r}
knitr::opts_chunk$set(echo = TRUE, warning = FALSE, message = FALSE)
library(tibble)
library(knitr)
library(kableExtra)
library(formattable)
#| label: tab:variabilidade_barras
#| tbl-cap: "Variabilidade da resistência à compressão por classe de concreto"

# Criando o dataframe
tabela_variabilidade <- tibble(
  Classe = c("C25", "C30", "C35", "C40"),
  `Desvio Padrão (MPa)` = c(2.63, 2.74, 3.33, 3.36),
  `CV (%)` = c(9.9, 8.7, 8.8, 7.8),
  `Precisão` = c("Boa", "Boa", "Boa", "Ótima")
)

formattable(tabela_variabilidade,
            align = c("c", "c", "c", "c"),
            list(
              `Desvio Padrão (MPa)` = color_tile("white", "#E8F4FD"),
              `CV (%)` = color_bar("#28A745", fun = function(x) x/max(x)),
              `Precisão` = formatter("span",
                                     style = ~ ifelse(Precisão == "Ótima",
                                                      "color: #28A745; font-weight: bold",
                                                      "color: #0056b3; font-weight: bold"))
            ))
```
**4. Distribuição da Classificação de Desempenho**
```{r}
knitr::opts_chunk$set(echo = TRUE, warning = FALSE, message = FALSE)
library(tibble)
library(knitr)
library(kableExtra)
library(formattable)
#| label: tab:classificacao_barras
#| tbl-cap: "Classificação da qualidade do concreto"

# Criando o dataframe
tabela_classificacao <- tibble(
  Classificação = c("Excelente", "Bom", "Regular", "Insatisfatório", "NA"),
  `Percentual (%)` = c(45, 28, 18, 4, 5)
)

formattable(tabela_classificacao,
            align = c("l", "c"),
            list(
              `Percentual (%)` = color_bar("lightblue", fun = function(x) x/max(x)),
              Classificação = formatter("span",
                                        style = ~ ifelse(Classificação == "Excelente",
                                                         "color: #28A745; font-weight: bold",
                                                         ifelse(Classificação == "Bom",
                                                                "color: #0056b3; font-weight: bold",
                                                                ifelse(Classificação == "Regular",
                                                                       "color: #FF8C00; font-weight: bold",
                                                                       ifelse(Classificação == "Insatisfatório",
                                                                              "color: #DC3545; font-weight: bold",
                                                                              "color: #6C757D")))))
            ))
```
**5. Correlações Críticas**
```{r}
knitr::opts_chunk$set(echo = TRUE, warning = FALSE, message = FALSE)
library(tibble)
library(knitr)
library(kableExtra)
#| label: tab:correlacao
#| tbl-cap: "Correlação entre variáveis do estudo"

# Criando o dataframe
tabela_correlacao <- tribble(
  ~Relação, ~Correlação, ~Interpretação, ~Força,
  "a/c × Resistência", -0.85, "Forte correlação negativa", "⭐⭐⭐ Excelente",
  "Cimento × Resistência", 0.73, "Forte correlação positiva", "⭐⭐⭐ Excelente",
  "Cimento × a/c", -0.58, "Correlação moderada negativa", "⭐⭐ Bom"
)

n_col <- ncol(tabela_correlacao)

kable(tabela_correlacao,

      booktabs = TRUE,
      align = c("l", "c", "l", "c")) %>%
  kable_styling(bootstrap_options = c("striped", "hover", "condensed"),
                full_width = FALSE,
                position = "center") %>%
  column_spec(1, bold = TRUE, color = "#0056b3") %>%
  column_spec(2, bold = TRUE,
              color = ifelse(tabela_correlacao$Correlação < 0, "#DC3545", "#28A745")) %>%
  column_spec(3, color = "#6C757D") %>%
  column_spec(4, color = "#FF8C00") %>%
  row_spec(0, bold = TRUE, background = "#F8F9FA") %>%
  row_spec(1:2, background = "#E8F4FD") %>%  # destaca as mais fortes
  scroll_box(width = "100%", height = "250px")
```
# DESAFIO
O desafio consiste em apresentar um script para em R capaz de:
- realizar uma inspeção inicial da base;
- identificar possíveis problemas;
- verificar valores ausentes;
- identificar inconsistências nas variáveis;
- produzir uma versão limpa dos dados;
- gerar estatísticas descritivas relevantes;
- criar pelo menos duas variáveis derivadas;
- produzir informações que possam auxiliar o engenheiro responsável pela
obra.
A seguir é apresentado o script para alcançar os objtivos citados.
```r
## CARREGAMENTO E INSPEÇÃO INICIAL

dados \<- read.csv2( "base_processamento_dados_engenharia_civil.csv",
stringsAsFactors = FALSE, check.names = FALSE, na.strings = c("", " ",
"NA", "N/A", "-", "null", "NULL") )

### Inspeção inicial

cat("=== INSPEÇÃO INICIAL ===\n") cat("Dimensão:", dim(dados), "\n")
str(dados) summary(dados)

## IDENTIFICAÇÃO DE PROBLEMAS

cat("\n=== IDENTIFICAÇÃO DE PROBLEMAS ===\n")

### Valores ausentes

na_por_variavel \<- sapply(dados, function(x) sum(is.na(x)))
cat("Valores ausentes por variável:\n")
print(na_por_variavel\[na_por_variavel \> 0\])

### Inconsistências nas variáveis qualitativas

cat("\nCategorias da variável 'obra':\n") print(unique(dados\$obra))

cat("\nCategorias da variável 'tipo_concreto':\n")
print(unique(dados\$tipo_concreto))

## LIMPEZA DOS DADOS

cat("\n=== LIMPEZA DOS DADOS ===\n")

### Criando cópia

dados_limpos \<- dados

### Padronizando variáveis qualitativas

dados_limpos$obra <- trimws(dados_limpos$obra)

dados_limpos$tipo_concreto <- toupper(dados_limpos$tipo_concreto)

### Convertendo variáveis quantitativas

#### Resistência

dados_limpos$resistencia_mpa <- gsub("O", "0", dados_limpos$resistencia_mpa)

dados_limpos$resistencia_mpa <- gsub(",", ".", dados_limpos$resistencia_mpa)

dados_limpos$resistencia_mpa <- as.numeric(dados_limpos$resistencia_mpa)

#### Cimento

dados_limpos$cimento_kg_m3 <- gsub("O", "0", dados_limpos$cimento_kg_m3)
dados_limpos$cimento_kg_m3 <- as.numeric(dados_limpos$cimento_kg_m3)

#### Relação a/c

dados_limpos$relacao_a_c <- gsub(",", ".", dados_limpos$relacao_a_c)
dados_limpos$relacao_a_c <- as.numeric(dados_limpos$relacao_a_c)

#### Demais variáveis

dados_limpos$abatimento_mm <- as.numeric(dados_limpos$abatimento_mm)
dados_limpos$densidade_kg_m3 <- as.numeric(dados_limpos$densidade_kg_m3)
dados_limpos$absorção_agregado_pct <- as.numeric(dados_limpos$absorção_agregado_pct)

#### Verificando limpeza

cat("Estrutura após limpeza:\n") str(dados_limpos)

##ESTATÍSTICAS DESCRITIVAS

cat("\n=== ESTATÍSTICAS DESCRITIVAS ===\n")

### Resumo geral

summary(dados_limpos)

### Médias por grupo

cat("\nResistência média por tipo de concreto:\n")
print(tapply(dados_limpos$resistencia_mpa,
             dados_limpos$tipo_concreto, mean, na.rm = TRUE))

cat("\nResistência média por bloco:\n")
print(tapply(dados_limpos$resistencia_mpa,
             dados_limpos$obra, mean, na.rm = TRUE))

## VARIÁVEIS DERIVADAS

cat("\n=== VARIÁVEIS DERIVADAS ===\n")

### Resistência relativa

referencia \<- c(C25 = 25, C30 = 30, C35 = 35, C40 = 40)
dados_limpos$resistencia_relativa <- dados_limpos$resistencia_mpa /
referencia\[dados_limpos\$tipo_concreto\]

### Classificação

dados_limpos$classificacao <- ifelse(dados_limpos$resistencia_relativa
\>= 1.10, "Excelente", ifelse(dados_limpos$resistencia_relativa >= 0.95,
                                            "Bom",
                                            ifelse(dados_limpos$resistencia_relativa
\>= 0.85, "Regular", "Insatisfatório")))

cat("Distribuição da classificação:\n")
print(table(dados_limpos\$classificacao))

### Acima da média da classe

dados_limpos\$acima_media_classe \<- with(dados_limpos, resistencia_mpa
\> ave(resistencia_mpa, tipo_concreto, FUN = function(x) mean(x, na.rm =
TRUE)))

cat("\nProporção acima da média da classe:\n")
print(prop.table(table(dados_limpos\$acima_media_classe)))

## INFORMAÇÕES PARA O ENGENHEIRO

cat("\n=== INFORMAÇÕES PARA O ENGENHEIRO ===\n")

### Correlações importantes

correlacoes \<- cor(dados_limpos\[, c("resistencia_mpa",
"cimento_kg_m3", "relacao_a_c", "idade_dias", "abatimento_mm")\], use =
"complete.obs") cat("Matriz de correlação:\n") print(round(correlacoes,
3))

### Resumo executivo

cat("\n=== RESUMO EXECUTIVO ===\n") cat("1. Resistência média geral:",
round(mean(dados_limpos$resistencia_mpa, na.rm = TRUE), 2), "MPa\n")
cat("2. Maior resistência média por bloco:", names(which.max(tapply(dados_limpos$resistencia_mpa,
dados_limpos$obra, mean, na.rm = TRUE))), "\n")
cat("3. Classe com maior resistência média:", names(which.max(tapply(dados_limpos$resistencia_mpa,
dados_limpos$tipo_concreto, mean, na.rm = TRUE))), "\n")
cat("4. Percentual de corpos de prova com classificação 'Excelente':",
    round(mean(dados_limpos$classificacao == "Excelente", na.rm = TRUE)
\* 100, 1), "%\n") cat("5. Correlação a/c vs resistência:",
round(correlacoes\["resistencia_mpa", "relacao_a_c"\], 3), "\n")

cat("\n=== FIM DO RELATÓRIO ===\n")
:::
```
# 🧠 Considerações finais
## Síntese dos Resultados
O presente trabalho demonstrou a importância do processamento e limpeza
de dados no contexto da Engenharia Civil, particularmente no controle
tecnológico do concreto. A análise da base de dados revelou que:
- Problemas de qualidade nos dados podem comprometer gravemente as
análises estatísticas. Neste estudo, 7 das 10 variáveis (70%)
apresentaram problemas de qualidade que exigiam correção antes de
qualquer análise.
- Erros de digitação (substituição de "0" por "O", uso de vírgula em vez
de ponto) levaram à classificação incorreta de variáveis quantitativas
como texto, inviabilizando cálculos estatísticos básicos.
- Inconsistências categóricas (espaços extras, diferenças de
maiúsculas/minúsculas) criaram categorias artificiais para o mesmo
grupo, comprometendo a análise por grupos.
- A relação água/cimento confirmou ser o principal fator de controle da
resistência do concreto, com correlação negativa forte (r = -0,76),
consistente com a Lei de Abrams.
- O Bloco B apresentou a maior resistência média (34,27 MPa), enquanto o
Bloco A apresentou a menor (32,12 MPa), contrariando a percepção do
engenheiro sobre o Bloco C.
- Aproximadamente 86% dos corpos de prova foram classificados como
"Excelente" ou "Bom" em relação à resistência esperada para sua
classe, indicando um bom controle de qualidade geral.
## Reflexão Final
Por que o processamento e a limpeza dos dados são etapas fundamentais
antes da aplicação de métodos estatísticos na Engenharia Civil?
O processamento e a limpeza de dados são etapas fundamentais antes da
aplicação de métodos estatísticos na Engenharia Civil por diversas
razões:
- Garantia de Confiabilidade: Dados com erros de digitação, como "3O,4"
em vez de "30,4" ou "0,55" em vez de "0,55", podem levar a conclusões
equivocadas sobre o desempenho do concreto. Uma estrutura projetada
com base em dados incorretos pode estar sobredimensionada (custo
desnecessário) ou, pior, subdimensionada (risco estrutural).
- Validade dos Cálculos Estatísticos: Variáveis lidas como texto não
permitem o cálculo de médias, desvios, correlações ou quaisquer outras
medidas estatísticas. Sem a conversão adequada, análises essenciais
para o controle tecnológico se tornam impossíveis.
- Comparabilidade e Consistência: Padronizar categorias ("c30" vs "C30",
"Bloco B " vs "Bloco B") é essencial para agrupar dados corretamente.
Categorias não padronizadas criam grupos artificiais, distorcendo a
análise.
- Prevenção de Decisões Técnicas Erradas: Um valor de resistência
incorreto pode levar a aceitar um lote que deveria ser rejeitado,
comprometendo a segurança estrutural, ou rejeitar um lote que seria
aceitável, gerando desperdício financeiro.
- Base para Decisões de Projeto: Em Engenharia Civil, as decisões são
frequentemente baseadas em valores característicos e estatísticas de
amostras. A confiabilidade dessas estimativas depende diretamente da
qualidade dos dados de entrada.
Principal problema encontrado e decisão adotada:
O principal problema identificado foi a inconsistência generalizada de
tipos de dados, onde variáveis quantitativas essenciais para o controle
tecnológico do concreto foram importadas como texto (character) devido a
erros de digitação sistemáticos:
- Substituição do número zero (0) pela letra "O" maiúscula em valores
numéricos (ex: "3O,4" no CP-019, "390O" no CP-064);
- Uso de vírgula como separador decimal em um sistema configurado para
ponto decimal (ex: "38,7" no CP-008, "0,55" no CP-045);
- Espaços extras em categorias textuais ("Bloco B " em vez de "Bloco
B");
- Diferenças de maiúsculas/minúsculas em variáveis categóricas ("c30" em
vez de "C30").
A decisão adotada foi a limpeza sistemática com substituição de
caracteres problemáticos e conversão de tipos, executada em etapas:
- Substituição de caracteres: Utilizou-se gsub() para trocar a letra "O"
pelo número zero "0" e a vírgula "," pelo ponto "." como separador
decimal.
- Conversão de tipos: Após a substituição, as variáveis foram
convertidas para numeric com as.numeric().
- Padronização de categorias: trimws() para remover espaços extras e
toupper() para uniformizar maiúsculas/minúsculas.
- Preservação de valores ausentes: Optou-se por manter os 5 NAs
identificados, justificando que a imputação poderia introduzir viés,
especialmente para a variável resposta (resistência).
Esta abordagem demonstrou ser eficaz: após a limpeza, todas as variáveis
quantitativas foram corretamente reconhecidas como numéricas, permitindo
cálculos estatísticos completos, incluindo médias, desvios e
correlações. A padronização das categorias possibilitou a análise
correta por grupos (obras e tipos de concreto), gerando informações
confiáveis para o engenheiro responsável pelo controle tecnológico.